CXL Interconnect 분석 — AI 시대 메모리 대역폭 확장
#한 줄 요약
“CXL은 PCIe 위에 cache coherency를 올린 interconnect입니다.” — CPU·가속기·메모리 풀이 같은 주소 공간을 공유하면서도 PCIe 인프라를 그대로 씁니다.
#어떤 문제를 푸는가
전통적인 PCIe 가속기는 별도 주소 공간에 살고, CPU와 데이터를 주고받으려면 매번 DMA를 명시적으로 돌려야 합니다. GPU에 텐서를 올렸다가 결과를 받아오는 코드를 떠올려 보면 cudaMemcpy가 줄줄이 등장하는 이유가 여기 있습니다. CPU와 가속기가 같은 자료구조를 coherent하게 볼 수 없기 때문입니다.
AI 워크로드는 이 한계를 점점 더 아프게 건드립니다. 모델 파라미터가 GPU HBM에 다 들어가지 않고, CPU DRAM에서 frequent하게 swap이 필요합니다. PCIe 5.0 x16의 원시 전송률은 한 방향 약 64 GB/s(32 GT/s × 16 ÷ 8)이고, 이 경로로 매번 복사하는 비용이 한계가 됩니다. 데이터 이동을 줄이거나 없애야 합니다.
CXL(Compute Express Link)은 이 문제를 두 방향으로 해결합니다. 첫째, cache coherency를 hardware에 위임해서 DMA 없이도 CPU·가속기가 같은 메모리를 봅니다. 둘째, memory expansion과 pooling을 가능하게 만들어서 한 서버가 수 TB의 unified memory를 쓸 수 있게 합니다.
이 글에서는 CXL의 세 프로토콜, Type 1/2/3 디바이스 분류, ARM Neoverse V2의 CHI-E와의 통합, 그리고 latency·대역폭의 실측 의미를 살펴봅니다.
#CXL 세대별 정리
| 세대 | 발표 | 기반 PCIe | 대역폭 (x16) | 주요 추가 |
|---|---|---|---|---|
| 1.1 | 2019 | PCIe 5.0 | 64 GB/s | 세 프로토콜, Type 1/2/3 |
| 2.0 | 2020 | PCIe 5.0 | 64 GB/s | switch, memory pooling, hot-plug |
| 3.0 | 2022 | PCIe 6.0 | 128 GB/s | fabric, peer-to-peer, multi-level switch |
| 3.1 | 2023 | PCIe 6.0 | 128 GB/s | TSP(TEE Security Protocol), fabric 확장 |
CXL 1.x는 direct attach만 가능했지만 2.0의 switch 도입으로 one-to-many fanout과 memory pool 구성이 가능해졌습니다. 3.x는 fabric으로 발전해 여러 host가 같은 메모리를 공유할 수 있습니다.
#세 프로토콜 — CXL.io·cache·mem
CXL 링크 위에는 세 프로토콜이 동시에 흐릅니다. 같은 PCIe PHY를 공유하면서 트래픽 타입에 따라 다른 의미를 가집니다.
| 프로토콜 | 용도 | 비유 |
|---|---|---|
| CXL.io | discovery, configuration, DMA | 기존 PCIe와 동일 |
| CXL.cache | device가 host memory를 coherent하게 cache | accelerator → CPU 메모리 읽기/쓰기 |
| CXL.mem | host가 device memory를 coherent하게 access | CPU → expander DRAM 직접 접근 |
CXL.io는 모든 디바이스에 필수입니다. PCIe 호환 enumeration을 위해서입니다. CXL.cache와 CXL.mem은 디바이스 타입에 따라 선택적입니다.
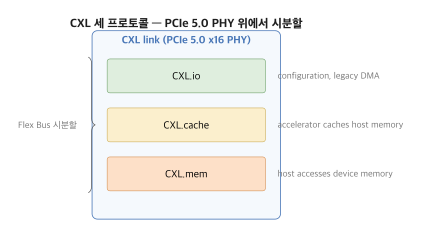
세 채널이 Flex Bus 위에서 시분할로 흐르고, 트랜잭션 종류에 따라 protocol layer가 라우팅합니다.
#Type 1/2/3 디바이스
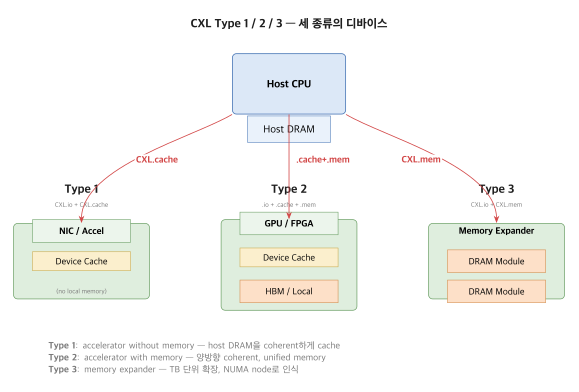
CXL 디바이스는 어떤 프로토콜을 쓰느냐로 세 분류로 나뉩니다.
| Type | 프로토콜 | 예시 | 특징 |
|---|---|---|---|
| Type 1 | CXL.io + CXL.cache | NIC, accelerator without local memory | host memory를 coherent하게 캐시 |
| Type 2 | CXL.io + CXL.cache + CXL.mem | GPU, FPGA with HBM | 양방향 coherent (host ↔ device memory) |
| Type 3 | CXL.io + CXL.mem | memory expander (CXL DDR module) | host에서만 access, device는 dumb memory |
Type 2가 가장 흥미롭습니다. GPU가 자기 HBM도 가지고 있으면서 CPU DRAM도 coherent하게 cache할 수 있습니다. 데이터 이동 없이도 진짜 unified memory가 가능해집니다.
Type 3는 데이터센터에서 DRAM bottleneck 완화에 쓰입니다. CPU 소켓의 DIMM slot 수가 모자랄 때 CXL.mem expander로 수 TB를 추가할 수 있습니다.
세 타입의 topology와 어떤 프로토콜이 어디로 흐르는지 한 그림으로 정리하면 다음과 같습니다.
#Neoverse V2와 CHI-E
Arm의 Neoverse V2 reference design(RD-V2) 기술 개요는 V2 코어 32개를 CMN-700 mesh로 묶습니다. CMN-700은 AMBA 5 CHI issue E(CHI-E)를 따르는 coherent mesh입니다.
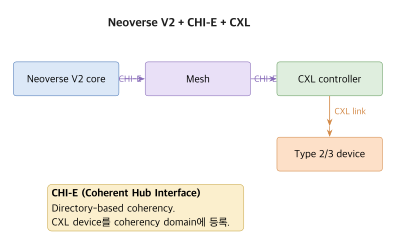
RD-V2 문서가 밝히는 구성:
| 항목 | RD-V2 |
|---|---|
| 코어 | Neoverse V2 32개, 코어당 private L2 2 MB |
| Interconnect | CMN-700 6×6 mesh, AMBA 5 CHI issue E |
| Home Node | Fully coherent HN-F 32개, SLC 32 MB, Snoop Filter 128 MB |
| 외부 링크 | 가속기용 CML 링크 8개(CML_SMP와 CXL 2.0 지원), chip/socket 간 CML_SMP 링크 8개 |
coherency는 HN-F의 snoop filter가 추적합니다(4-09편 참고). CXL 2.0 가속기는 이 CML 링크로 같은 mesh에 붙습니다.
#코드 — Type 3 expander 인식
Linux에서 CXL.mem expander는 별도 NUMA node로 인식됩니다.
# CXL memory device 확인$ ls /sys/bus/cxl/devices/
# NUMA topology — CXL 메모리는 CPU 없는 노드로 보임$ numactl --hardwareCXL expander는 coreless NUMA node입니다. node distances 값은 펌웨어(ACPI)가 주는 상대값이므로 실제 지연은 직접 잽니다. 자주 쓰는 데이터는 local, cold 데이터를 CXL에 두는 tiered memory 전략이 자연스럽습니다.
#측정 — Latency penalty
실제 CXL 메모리 디바이스 3종을 Intel Sapphire Rapids 서버에서 잰 연구(Sun et al., MICRO 2023)의 load 지연입니다. 기준은 원격 소켓 DDR5입니다.
| 메모리 | load 지연, 원격 소켓 DDR5 대비 |
|---|---|
| CXL-A | 약 1.35배 |
| CXL-B | 약 2배 |
| CXL-C | 약 3배 |
같은 direct attach라도 CXL 컨트롤러 설계에 따라 지연이 크게 갈립니다. switch 경유와 CXL.cache의 실측은 이 글의 자료에 없습니다(TBD).
// 간단한 latency 측정void measure_latency(void *buf, size_t size) { uint64_t start, end; volatile uint64_t *p = buf; asm volatile("mrs %0, cntvct_el0" : "=r"(start)); for (int i = 0; i < 1000000; i++) { p = (uint64_t *)*p; // pointer chase — cache miss 강제 } asm volatile("mrs %0, cntvct_el0" : "=r"(end)); printf("Avg latency: %lu ns\n", (end - start) / 1000000);}Buf를 local·remote·CXL 노드에 각각 할당해(numactl --membind) 같은 코드를 돌리면 내 시스템의 비율이 나옵니다. cntvct_el0는 tick 단위이므로 cntfrq_el0로 나눠 ns로 바꿔야 합니다.
#대역폭 — Peak vs Sustained
CXL 2.0 x16 링크의 원시 전송률은 한 방향 약 64 GB/s입니다. 실효 대역폭은 flit·프로토콜 오버헤드와 디바이스 구현에 따라 그보다 낮고, 그 비율은 STREAM·mlc로 직접 잽니다.
- 68B flit은 2 B Protocol ID + 16 B slot 4개 + 2 B CRC로 구성되므로(CXL 3.1 §4.2) 64 B 데이터마다 헤더·CRC가 붙습니다.
- CXL.io와 CXL.cache·CXL.mem이 같은 링크를 나눠 쓰므로 트래픽이 섞이면 서로의 몫이 줄어듭니다.
#CXL.cache 트랜잭션 흐름
CXL.cache는 MESI 같은 coherency 프로토콜을 device-host 간에 확장합니다.
| 단계 | 메시지 |
|---|---|
| 1 | Device → host: D2H 읽기 요청 (예: RdShared, RdOwn) |
| 2 | Host: 다른 cache가 그 line을 가졌는지 확인하고 필요하면 snoop |
| 3 | Host → device: GO 응답(부여한 MESI 상태)과 데이터 |
| 4 | Host CPU가 같은 line에 쓰려 하면 host → device H2D snoop(SnpInv) |
| 5 | Device → host: snoop 응답(필요하면 dirty data) |
opcode 이름은 CXL 3.1 spec의 D2H 요청·H2D snoop 목록을 따릅니다. 별도의 “Invalidate” opcode는 없고, host가 device cache의 line을 무효화할 때는 SnpInv snoop을 씁니다. host와 device가 번갈아 같은 line을 건드리면 요청·snoop이 왕복하는 coherency ping-pong이 생깁니다.
#자주 보는 함정과 안티패턴
⚠️ CXL.cache에서 false sharing
같은 64-byte 라인을 host와 device가 번갈아 쓰면 매번 D2H 요청과 H2D snoop이 링크를 왕복합니다. alignas(64)로 라인을 분리하고, 디바이스가 쓰는 영역과 호스트가 쓰는 영역을 page 단위로 나누는 게 안전합니다.
⚠️ CXL.mem을 hot data 저장소로 사용
CXL.mem expander는 cold tier입니다. Hot working set을 CXL에 두면 cache miss마다 local DRAM보다 긴 지연을 냅니다. numactl --membind나 mbind()로 hot allocation을 local node에 고정합니다.
⚠️ Peak 대역폭 가정
원시 전송률 64 GB/s를 그대로 가정하고 throughput 모델을 세우면 실측과 어긋납니다. 처음부터 STREAM·mlc로 잰 sustained 값으로 설계합니다.
#정리
- CXL은 PCIe 5.0/6.0 PHY 위에 cache coherency를 올린 interconnect입니다.
- 세 프로토콜(CXL.io, CXL.cache, CXL.mem)이 같은 링크에서 시분할로 흐릅니다.
- Type 1은 가속기, Type 2는 메모리 가진 가속기, Type 3은 메모리 expander입니다.
- Arm RD-V2는 CHI issue E 기반 CMN-700 mesh에 CXL 2.0 링크 8개를 둡니다.
- 실제 CXL 디바이스의 load 지연은 원격 소켓 DDR5의 1.35배~약 3배로 디바이스마다 갈립니다(MICRO 2023). 대역폭은 직접 잽니다.
- CXL.cache에서 host·device가 같은 line을 번갈아 쓰면 요청·snoop이 왕복하므로 line 분리가 중요합니다.
다음 편은 3-12: 차세대 SoC 트렌드 — chiplet, 3D stacking, near-memory compute를 정리합니다.
#관련 항목
Embedded Performance Engineering · 30 of 57
- 1 Embedded Performance Engineering — 임베디드 성능 엔지니어링 시리즈 소개
- 2 임베디드 성능 분석 방법론 — Measure → Analyze → Optimize 사이클
- 3 성능 지표 정의 — Latency·Throughput·Utilization 분석
- 4 성능 측정의 기본 — Wall-Clock·CPU Cycle·Instruction Count
- 5 성능 데이터 통계적 분석 — Percentile·Histogram·평균의 함정
- 6 실시간 성능 분석 — WCET·Jitter·Deadline Miss 측정
- 7 임베디드 벤치마킹 기초 — 재현성·Warmup·노이즈 제거
- 8 성능 모델링 — Amdahl·Gustafson·Roofline Model 적용
- 9 프로파일링 기법 개요 — Sampling vs Instrumentation·PGO·LTO
- 10 CPU 파이프라인 분석 — 5-stage·Cortex-M·Cortex-A 비교
- 11 Pipeline Stall 분석 — Data·Structural·Control Hazard·Forwarding
- 12 Branch Prediction 분석 — Static·2-bit·BTB·BHT·Mispredict 비용
- 13 Speculative Execution 분석 — OoO·Reorder Buffer·Register Renaming
- 14 CPU Cache 기초 — L1·L2·L3·Set Associative·Replacement Policy
- 15 Cache Miss 3C Model 분석 — Compulsory·Capacity·Conflict
- 16 Cache Line 최적화 — Alignment·Prefetch·False Sharing 처리
- 17 메모리 대역폭 분석 — STREAM·Roofline·Bus Saturation 측정
- 18 SIMD·NEON 활용 — 128-bit Vector·Auto-Vectorization·SVE/SVE2
- 19 PMU·HPM 하드웨어 카운터 분석 — 정밀 성능 진단
- 20 임베디드 Bus Architecture — AHB·AXI·CHI 진화와 5-Channel
- 21 Bus Contention 진단 — Arbitration·QoS·Starvation 측정
- 22 DMA 성능 최적화 — Burst·Scatter-Gather·Chain·Cache 일관성
- 23 DMA vs CPU Copy 성능 비교 — Break-even·Setup Overhead 실측
- 24 Interrupt Latency 분석 — 진입·종료·Tail-Chaining·Late Arrival
- 25 Interrupt Storm 처리 — NAPI·Rate-Limit·Polling 전환
- 26 MMIO 접근 성능 — Cache Policy·Write-Combining·Volatile·Barrier
- 27 Peripheral Clock 분석 — PLL·Divider·Gating·DVFS
- 28 Power vs Performance 트레이드오프 — DVFS·Race-to-Idle·Big.LITTLE
- 29 Thermal Throttling 분석 — Junction Temp·Trip Point·냉각
- 30 CXL Interconnect 분석 — AI 시대 메모리 대역폭 확장
- 31 Concurrency 기초 — Concurrency vs Parallelism·Race·Memory Model
- 32 False Sharing 진단 — Cache Line Ping-Pong·Padding·측정
- 33 Lock Contention 분석 — Wait·Hold·Convoy·측정 기법
- 34 Spinlock 성능 분석 — Spin-Wait vs Context Switch·Ticket·MCS
- 35 Mutex 성능 분석 — Futex·Adaptive·Priority Inheritance
- 36 Reader-Writer Lock 성능 — Reader/Writer Priority·RCU·Seqlock
- 37 Lock-Free 자료구조 성능 — CAS·ABA·Hazard Pointer·Epoch Reclamation
- 38 Memory Ordering 분석 — Acquire·Release·Seq-Cst·ARM Relaxed Model
- 39 Cache Coherency 프로토콜 — MESI·MOESI·Snoop·Directory
- 40 SMP 성능 분석 — Per-Core·Affinity·Load Balance·Scalability
- 41 Linux perf 기초 — stat·record·report 활용
- 42 Linux perf 고급 — Raw Event·Tracepoint·perf script
- 43 ftrace 활용 — function·function_graph·latency tracer
- 44 eBPF·bpftrace 동적 트레이싱 — 커널 무수정 관측
- 45 Flamegraph 분석 — On-CPU·Off-CPU·Differential
- 46 ARM DS·Lauterbach 분석 — Hardware Trace 전문 도구
- 47 Bare-metal 프로파일링 — GPIO·DWT·SysTick·ITM 활용
- 48 NVIDIA Nsight Systems — GPU·NPU 포함 시스템 분석
- 49 모던 프로파일러 비교 — Tracy·Hotspot·uftrace·Coz
- 50 연속 프로파일링 — Parca·Pixie·Pyroscope·Tetragon
- 51 실전 사례 — ISR Latency 100µs Deadline Miss 추적
- 52 실전 사례 — Matrix Multiply가 예상의 10배 느린 이유
- 53 실전 사례 — 8-core가 4-core를 넘으면 throughput이 떨어지는 이유
- 54 실전 사례 — 카메라 1080p 60fps가 30fps로 떨어지는 이유
- 55 CXL.mem 지연·대역폭 실측 — Direct·Switch·Pooled 토폴로지 비교
- 56 CXL 성능 프로파일링 도구 — cxl-cli·DAMON·perf-mem 활용
- 57 실전 사례 — CXL.mem 추가로 LLM inference KV cache 처리량 회복
관련 글
Concurrency 기초 — Concurrency vs Parallelism·Race·Memory Model
Concurrency vs Parallelism (Rob Pike). Race condition. Memory model 도입.
같은 시리즈에서 이어 읽기
False Sharing 진단 — Cache Line Ping-Pong·Padding·측정
False sharing 원인. Cache coherence ping-pong. Padding으로 line 분리. 측정 방법.
같은 시리즈에서 이어 읽기
PCIe → CXL 진화 — 같은 PHY 위 cache-coherent 프로토콜 추가
PCIe 5.0/6.0 PHY 위에서 CXL이 어떻게 cache coherency를 얹는지 — Flex Bus, 세 프로토콜 다중화, Type 1/2/3 디바이스 구분.
공통 태그 기반 추천
이 글을 참조하는 글 (7)
- PCIe → CXL 진화 — 같은 PHY 위 cache-coherent 프로토콜 추가 — Modern Embedded Recipes
- 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일 — HBM·GDDR 심화
- CXL Type 1·2·3 디바이스 분류 — 이 중 무엇이 나에게 메모리인가 — HBM·GDDR 심화
- Ch 18: Register Maps — Config Space·Capability 비트 reference — PCIe Deep Dive
- Ch 1: PCIe Fundamentals — 계층 구조와 토폴로지 — PCIe Deep Dive
- Ch 1: CXL의 자리와 진화 — 1.1에서 4.0까지 — CXL 4.0 Internals
- CXL.mem 지연·대역폭 실측 — Direct·Switch·Pooled 토폴로지 비교 — Embedded Performance Engineering