Cache Line Alignment — alignas·Padding·SoA 적용
#한 줄 요약
“Cache line alignment는 false sharing을 줄이는 한 수단입니다.” 실제 line 크기와 allocator/container layout을 확인하고 element 사이 padding을 설계합니다.
#어떤 상황에서 쓰나
멀티코어 SMP에서 카운터 두 개를 두 코어가 각각 증가시키는데도 throughput이 코어 하나일 때보다 느려질 수 있습니다. 두 변수가 같은 cache line 안에 있으면 coherency traffic이 늘 수 있으며, 저하 폭은 CPU topology와 workload로 측정합니다.
DMA buffer를 cacheable 영역에 두면 line 경계가 어긋난 곳에서 invalidate가 옆 line까지 건드리면서 다른 코드의 hot data를 날립니다. 이런 상황을 만나면 alignment가 가장 먼저 의심해야 할 항목입니다.
#핵심 개념
두 hot counter가 같은 line에 있을 때와 line이 분리된 경우의 차이를 그림으로 먼저 봅니다.
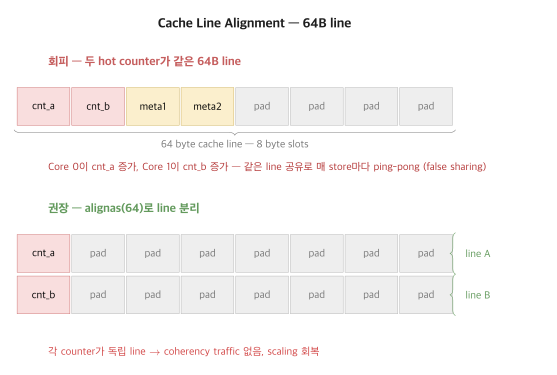
Cache line은 CPU cache coherence와 fetch의 기본 단위입니다. 실제 line 크기는 CPU·cache level·platform에 따라 확인해야 하며, 같은 line의 독립 변수는 coherency traffic을 공유할 수 있습니다.
/* C++17 */#include <new>constexpr size_t CACHE_LINE = std::hardware_destructive_interference_size;
/* Runtime */long line_size = sysconf(_SC_LEVEL1_DCACHE_LINESIZE);칩별 line 크기를 기억해두는 편이 좋습니다.
| Architecture | Line size |
|---|---|
| architecture | line size |
| ARM Cortex-M7 | SoC/reference manual 확인 |
| ARM Cortex-A | CPU/cache level 확인 |
| x86 | CPU/cache level 확인 |
| 기타 | platform 문서 확인 |
#코드 / 실제 사용 예
#alignas로 struct 시작 정렬
#include <cstddef>#include <atomic>
struct alignas(64) hot_data { std::atomic<int> counter;};
hot_data g_data; /* &g_data % 64 == 0 보장 */C11도 _Alignas(64), GCC·Clang은 __attribute__((aligned(64)))를 지원합니다.
#Element 사이 padding으로 false sharing 차단
struct counters { alignas(64) std::atomic<int> a; char pad_a[64 - sizeof(std::atomic<int>)];
alignas(64) std::atomic<int> b; char pad_b[64 - sizeof(std::atomic<int>)];};
static_assert(sizeof(counters) == 128, "padded counters");alignas만 쓰면 struct 시작만 정렬되고 element 사이는 그대로 붙습니다. 카운터 두 개가 한 line에 들어가면 padding이 의미를 잃습니다.
#SPSC ring buffer head/tail 분리
template<typename T, size_t N>struct spsc_ring { alignas(64) std::atomic<size_t> head; char pad_h[64 - sizeof(std::atomic<size_t>)];
alignas(64) std::atomic<size_t> tail; char pad_t[64 - sizeof(std::atomic<size_t>)];
alignas(64) T buf[N];};Producer는 head만 쓰고 consumer는 tail만 씁니다. 두 변수가 서로 다른 line에 있으면 coherency traffic이 0에 수렴합니다.
#AoS → SoA 변환
/* AoS — 한 particle을 다 fetch */struct particle { float x, y, z, vx, vy, vz, mass; };particle parts[N];
for (int i = 0; i < N; i++) { parts[i].x += parts[i].vx * dt; /* y, z, mass까지 같은 line에 fetch — 60% 낭비 */}
/* SoA — x, vx만 fetch */struct particles_soa { alignas(64) float x[N]; alignas(64) float y[N]; alignas(64) float vx[N]; alignas(64) float vy[N];};
for (int i = 0; i < N; i++) { parts.x[i] += parts.vx[i] * dt;}SoA는 SIMD 친화이기도 합니다. NEON vld1q_f32(&parts.x[i])로 4개 float을 한 번에 load할 수 있습니다.
#Hot/Cold 분리
struct guest { /* Hot — 매 frame 접근 */ alignas(64) int id; int active; int last_login; char pad[64 - 3 * sizeof(int)];
/* Cold — 화면에 표시할 때만 */ char email[128]; char address[256];};자주 접근하는 필드는 line 하나에 모으고, 드물게 보는 필드는 별도 line으로 밀어둡니다. Hot loop이 한 line만 가져가도록 만드는 것이 목표입니다.
#Per-CPU counter
struct counter_per_cpu { alignas(64) atomic_long value;} per_cpu_counters[NUM_CORES];
void inc(int cpu) { atomic_fetch_add(&per_cpu_counters[cpu].value, 1);}
long sum_all(void) { long s = 0; for (int i = 0; i < NUM_CORES; i++) s += atomic_load(&per_cpu_counters[i].value); return s;}코어별로 다른 line을 쓰면 false sharing을 줄일 수 있지만, scaling은 memory ordering·scheduler·접근 패턴으로 측정해야 합니다.
#Linux 커널 매크로
#include <linux/cache.h>
struct foo { int a; int b ____cacheline_aligned; /* 새 line */};
static struct bar ____cacheline_aligned g_bar;커널은 ____cacheline_aligned를 표준 매크로로 씁니다. Per-CPU data와 hot field에 광범위하게 적용되어 있습니다.
#측정 / 성능 비교
Cortex-A72 quad core에서 atomic counter 두 개를 두 thread가 1억 번 증가시킨 결과입니다.
| 구조 | 시간 | throughput |
|---|---|---|
| 같은 line에 a, b | workload별 측정 | 측정 필요 |
| alignas(64)만 (시작) | workload별 측정 | 측정 필요 |
| element 사이 padding | workload별 측정 | 측정 필요 |
false sharing 완화 효과는 workload와 CPU topology에 따라 측정합니다.
NEON aligned vs misaligned load (Cortex-A72)aligned vld1q_f32 1 cycle/loadmisaligned vld1q_f32 2 cycle/load (cross-line)ARM Cortex-A는 misalign을 허용하지만 cross-line transaction이 발생하면 두 배가 듭니다. 정렬은 공짜에 가까운 최적화입니다.
#자주 보는 함정
alignas만 쓰고 element 정렬을 잊은 경우
struct foo { alignas(64) int a; int b; /* a와 같은 line — padding 없음 */};다음 element에도 alignas를 붙이거나 명시적 padding을 넣어야 합니다.
Stack 변수에 큰 alignment 가정
void func(void) { alignas(64) int x; /* stack은 16/32B만 보장하는 경우 많음 */}GCC의 -mstackrealign을 켜거나 static·heap으로 옮기는 편이 안전합니다.
32B line 칩에 64 alignment
/* Cortex-M7 line = 32 B */alignas(64) int x; /* 메모리 두 배 낭비 */칩별 line 크기를 확인하고 그 단위로 맞추는 것이 좋습니다.
__attribute__((packed))남용
struct { char c; int i;} __attribute__((packed)); /* i가 misaligned → Cortex-M0/ARMv6 fault */Packed는 전송 프로토콜용에만 쓰고 일반 in-memory struct는 natural alignment를 유지합니다.
DMA buffer 정렬 누락
uint8_t buf[1024]; /* alignment 1 — neighbor line 영향 */SCB_CleanDCache_by_Addr((uint32_t*)buf, 1024);DMA buffer는 반드시 cache line 단위로 정렬해야 invalidate가 옆 line의 hot data를 건드리지 않습니다.
#정리
alignas(64)는 struct 시작만 정렬하므로 element 사이에도 padding이 필요합니다.- False sharing 제거는 SMP에서 흔히 8~10배 throughput을 회복시킵니다.
- AoS를 SoA로 바꾸면 cache 효율과 SIMD 친화성이 동시에 좋아집니다.
- Hot/cold 분리는 hot loop이 line 하나만 fetch하도록 만드는 가장 단순한 기법입니다.
- Per-CPU counter는 line 단위 분리만으로 코어 수에 선형 scaling을 얻습니다.
- Cortex-M7은 32B line, Apple M1은 128B line이므로 칩별 size를 확인해야 합니다.
- Linux 커널은
____cacheline_aligned를 표준으로 사용합니다.
다음 편은 DMA Allocator입니다.
#관련 항목
Modern Embedded Recipes · 92 of 152
- 1 Modern Embedded Recipes — 모던 임베디드 실전 레시피 시리즈 소개
- 2 디지털 신호 기초 — Voltage Level·Edge·Setup/Hold 분석
- 3 임베디드 클럭과 타이밍 — Skew·Jitter·PLL·MMCM 분석
- 4 GPIO 내부 구조 분해 — Push-Pull·Open-Drain·Schmitt Trigger
- 5 UART 하드웨어 동작 분석 — Baud Rate·Framing·FIFO
- 6 SPI 하드웨어 분석 — Clock Mode·MOSI/MISO·Chip Select
- 7 I2C 하드웨어 분석 — Open-Drain·Clock Stretching·Arbitration
- 8 ADC 동작 원리 — SAR·Sigma-Delta·Pipelined 비교
- 9 DAC 동작 원리 — R-2R Ladder·Sigma-Delta·Settling Time
- 10 PWM 신호 생성 분석 — Duty·Frequency·Dead Time·Center-Aligned
- 11 CAN 버스 전기적 특성 — Differential·Termination·Dominant/Recessive
- 12 RS-485·RS-422 차동 신호 분석 — Termination·Biasing·Topology
- 13 LVDS 차동 신호 분석 — Common-Mode·Impedance·Eye Pattern
- 14 ARM Cortex-M 시리즈 비교 — M0·M3·M4·M7·M33·M55 분석
- 15 ARM Cortex-A 시리즈 비교 — A53·A55·A72·A78·X1 분석
- 16 Cortex-M 레지스터 구조 분석 — R0~R15·xPSR·CONTROL·Mask Registers
- 17 Cortex-M 예외 처리 — Vector Table·NVIC·Tail-Chaining 추적
- 18 ARM 메모리 맵 분석 — Normal·Device·Strongly-Ordered Region
- 19 ARM L1·L2 캐시 분석 — Set Associative·Inclusive·Maintenance
- 20 ARM MPU 활용 — Region·Attribute·Privilege Separation
- 21 ARM MMU 기초 분석 — Translation Table·TLB·ASID
- 22 ARM TrustZone-M 기초 — Secure/Non-Secure·NSC·MPC
- 23 ARM Memory Barrier 실전 — DMB·DSB·ISB·DMA·MMIO
- 24 임베디드 크로스 컴파일러 분석 — GCC·Clang·Sysroot 구성
- 25 C 컴파일 4단계 — Preprocess·Compile·Assemble·Link 추적
- 26 ELF 파일 구조 분석 — Section·Segment·Symbol Table·DWARF
- 27 링커 스크립트 기초 — SECTIONS·MEMORY·entry point
- 28 링커 스크립트 고급 — Overlay·BSS·init_array·LMA/VMA
- 29 임베디드 스타트업 코드 분석 — Reset_Handler·Vector Table·SystemInit
- 30 C 런타임 crt0 분석 — Stack·BSS Zero·Data Copy·atexit
- 31 임베디드 메모리 레이아웃 — .text·.rodata·.data·.bss·.heap·.stack
- 32 임베디드 컴파일러 최적화 분석 — -O0~-O3·-Os·-LTO 비교
- 33 Map 파일 분석 — Symbol·Section·Size 추적으로 코드 크기 진단
- 34 Make·CMake 크로스 컴파일 — Toolchain File·Sysroot 통합
- 35 임베디드 Bootloader 체인 — BootROM·SPL·U-Boot·Kernel·Secure Boot
- 36 첫 bare-metal 프로그램 작성 — Linker·Startup·main의 최소 구성
- 37 MMIO 레지스터 직접 접근 — volatile·Memory Map·Aliasing 분석
- 38 GPIO 드라이버 직접 구현 — STM32 HAL 없이 레지스터로
- 39 임베디드 클럭 설정 분석 — HSE·PLL·SYSCLK·AHB/APB 분주
- 40 Cortex-M 인터럽트 핸들링 — NVIC·Priority·Vector·EXTI
- 41 SysTick 타이머 활용 — 24-bit Counter·1ms Tick·delay 구현
- 42 UART 드라이버 구현 — polling·interrupt·DMA 3가지 방식 비교
- 43 SPI 드라이버 구현 — Master·Slave·CRC·DMA
- 44 I2C 드라이버 구현 — Master·7-bit/10-bit·Clock Stretching 처리
- 45 임베디드 DMA 기초 — Memory-to-Memory·Peripheral·Circular Mode
- 46 저전력 모드 분석 — Sleep·Stop·Standby·Wake-up Source
- 47 IWDG·WWDG 워치독 구현 — Independent vs Window 비교
- 48 임베디드 Flash 프로그래밍 — Erase·Program·Read While Write
- 49 DDR 초기화 실패 진단 — Timing·Calibration·Walking Bit Test
- 50 PWM 출력 실전 — LED 밝기·모터 속도 제어
- 51 DC 모터 제어 — H-Bridge·PWM Duty·Encoder Feedback
- 52 스테퍼 모터 제어 — Full Step·Half Step·Microstepping
- 53 서보 모터 제어 — PWM 1ms~2ms·Closed Loop·PID
- 54 Character LCD 제어 — HD44780·4-bit Mode·Custom Char
- 55 SPI OLED 제어 — SSD1306·Frame Buffer·Page 단위 갱신
- 56 TFT 디스플레이 구동 — RGB565·FSMC·LTDC·DMA2D
- 57 환경 센서 활용 — BME280 온습압·SHT3x 비교
- 58 IMU 센서 활용 — MPU6050·BMI270·Sensor Fusion
- 59 CAN 통신 구현 — bxCAN·Filter·Mailbox·CAN-FD
- 60 USB Device 기초 — Descriptor·Enumeration·Endpoint·HID/CDC
- 61 Ethernet MAC+PHY 통합 — RMII·lwIP·DMA Descriptor
- 62 SD Card + FatFs 구현 — SPI/SDIO 모드·CSD/CID·Wear
- 63 RTC 활용 — Calendar·Alarm·Wake-up Timer·Backup Domain
- 64 RTOS 도입 결정 분석 — Super Loop vs RTOS 트레이드오프
- 65 RTOS Task 설계 패턴 — 우선순위·스택·State Machine
- 66 RTOS Scheduler 동작 분석 — Tick·Context Switch·Yield
- 67 RTOS Semaphore 활용 — Binary·Counting·ISR Give
- 68 RTOS Mutex 활용 — Recursive·Priority Inheritance 적용
- 69 RTOS Queue 활용 — By-Value·By-Reference·Timeout 패턴
- 70 RTOS Event Group 활용 — Bit Wait·Sync·Notify
- 71 RTOS Software Timer 활용 — One-shot·Auto-reload·Daemon Task
- 72 ISR-Safe API 설계 — Reentrant·Atomic·Defer 패턴
- 73 Priority Inversion 진단·예방 — Mars Pathfinder Lesson 추적
- 74 Timer Wheel 분석 — Hashed·Hierarchical·O(1) Tick
- 75 RTOS 디버깅 기법 — Tracealyzer·SystemView·Stack 추적
- 76 임베디드 Linux 부팅 흐름 분석 — BootROM·U-Boot·Kernel·init
- 77 U-Boot 활용 — bootcmd·env·tftp·boot.scr 분석
- 78 Device Tree 실전 — DTS·DTB·Overlay·Phandle 추적
- 79 Device Tree Overlay 적용 — Runtime fragment·dtoverlay
- 80 임베디드 커널 빌드 — defconfig·menuconfig·Image·zImage
- 81 커널 모듈 기초 — init/exit·Parameter·KBuild·DKMS
- 82 캐릭터 드라이버 작성 — file_operations·cdev·register_chrdev
- 83 Platform 드라이버 작성 — probe·remove·of_match·DT 바인딩
- 84 mmap 4가지 모드 — Anonymous·File·Shared·Huge Page
- 85 epoll 실전 — LT·ET·ONESHOT·EXCLUSIVE 비교
- 86 UIO·VFIO 분석 — User-Space Driver와 IOMMU 격리
- 87 sysfs·configfs 활용 — kobject 기반 User 인터페이스
- 88 IRQ Affinity 튜닝 — smp_affinity·isolcpus·irqbalance
- 89 루트 파일시스템 구축 — Buildroot 기초·Package·Toolchain
- 90 임베디드 동적 메모리 — malloc 위험·결정성·대안 분석
- 91 메모리 정렬과 패딩 분석 — Natural·Strict Alignment·Trap
- 92 Cache Line Alignment — alignas·Padding·SoA 적용
- 93 DMA-Friendly Allocator — dma_alloc_coherent·IOMMU·Pool
- 94 Zero-Copy Pipeline — DMA-BUF·sendfile·io_uring·splice
- 95 NUMA Memory Topology — numactl·numa_alloc·HBM 적용
- 96 SIMD 활용 분석 — Intrinsics·Auto-Vectorization·OpenMP SIMD
- 97 ARM NEON 심화 — Matrix Multiply·FFT·Image Filter 적용
- 98 임베디드 스택 분석 — high-water·overflow 탐지
- 99 임베디드 코드 크기 최적화 — -Os·LTO·Section Garbage Collection
- 100 임베디드 전력 최적화 — Sleep Mode·Clock Gating·DVFS
- 101 WCET 분석 기법 — Static·Measurement·Hybrid 방법론
- 102 Lock-Free Ring Buffer 구현 — SPSC·Power-of-2·Memory Order
- 103 Wait-Free Signaling — Atomic Flag·Sequence·Latest-Value
- 104 RCU (Read-Copy-Update) 기초 — Quiescent State·Grace Period
- 105 Hazard Pointer 분석 — Lock-Free Memory Reclamation
- 106 Compare-And-Swap 패턴 — Stack·Counter·Linked List 적용
- 107 Atomic Operation 비용 분석 — Fence·Cache Line·Contention
- 108 Spinlock vs Mutex 결정 가이드 — Context Switch·Hold Time
- 109 ABA 문제 회피 — Tagged Pointer·Hazard·Generation Counter
- 110 False Sharing 해결 — Cache Line Padding·SoA 적용
- 111 MPMC Queue 구현 — Multi-producer Multi-consumer Lock-Free
- 112 임베디드 디버깅 마인드셋 — 가설·격리·재현·이분탐색
- 113 JTAG·SWD 안 붙을 때 — 핀·전압·속도·세션 진단
- 114 GDB 원격 디버깅 — OpenOCD·J-Link·target remote 구성
- 115 Cortex-M 하드폴트 분석 — Stacked Frame·CFSR 읽기
- 116 UART 안 찍힐 때 — Bare-metal 체크리스트
- 117 임베디드 부팅 실패 진단 — 단계별 Isolation
- 118 인터럽트 누락·중복 진단 — Priority·Pending·Re-entry 추적
- 119 메모리 오버플로우·오염 진단 — Canary·MPU·Pattern 분석
- 120 타이밍·Race 진단 — Heisenbug 잡는 법
- 121 통신 프로토콜 분석 — Logic Analyzer와 Protocol Decoder
- 122 임베디드 로깅 시스템 설계 — 레벨·버퍼·SWO·Deferred
- 123 임베디드 포스트모템 분석 — Core Dump와 Field Crash
- 124 FPGA 기초 분석 — LUT·FF·BRAM·DSP 자원 구조
- 125 Vivado 사용법 — Project·Constraint·Synth·Impl·Bitstream
- 126 PCIe BAR 매핑 분석 — Config Space·Enumeration·MMIO 접근
- 127 AXI 인터페이스 — AXI4·AXI4-Lite·AXI-Stream 비교
- 128 Zynq PS-PL 통신 — GP·HP·ACP 인터페이스 선택
- 129 Mailbox Protocol 분석 — Host와 Accelerator를 잇는 Doorbell
- 130 Command Queue·Submission Queue — NVMe·XDMA 공통 패턴
- 131 DMA Completion 메커니즘 — Interrupt·Polling·Completion Ring
- 132 PCIe Streaming 분석 — BAR Type·MSI-X·Kernel Bypass
- 133 Vitis HLS 분석 — Pragma·Pipeline II·Dataflow 실전 감각
- 134 HLS 최적화 기법 — Pipeline·Unroll·Partition·Dataflow
- 135 Vitis AI 분석 — DPU·xmodel·VART
- 136 OpenCL on FPGA — Kernel·Channel·Burst Memory 분석
- 137 Intel Quartus 사용법 — Platform Designer·Nios II·HLS
- 138 Edge Inference 분석 — Cloud vs Edge·Latency·Privacy
- 139 NPU 아키텍처 분석 — Ethos·Hexagon·Systolic Array 비교
- 140 딥러닝 Quantization 분석 — PTQ·QAT·INT8·INT4·Calibration
- 141 TensorRT 분석 — ONNX→Engine·FP16·INT8·DLA·Multi-Stream
- 142 TFLite Micro 분석 — Op Resolver·Tensor Arena·Cortex-M
- 143 ONNX Runtime 분석 — Execution Provider와 Cross-Platform 배포
- 144 Edge Thermal Management — Throttling·DVFS·Fan Curve·Sustained
- 145 NVIDIA Jetson 분석 — Nano·Xavier·Orin·Thor·JetPack·DLA·VPI
- 146 Zero-Copy Camera Pipeline — V4L2·DMA-BUF·GPU Import·NPU 직결
- 147 온디바이스 LLM 추론 — llama.cpp·GGUF·MLX·KV Cache·NPU Backend
- 148 Cortex-M33 TF-M·TrustZone — Secure Firmware·PSA·MCUboot
- 149 Matter·Thread 분석 — IoT 통합 표준·Commissioning·Multi-Fabric
- 150 PCIe → CXL 진화 — 같은 PHY 위 cache-coherent 프로토콜 추가
- 151 QEMU CXL Type 3 디바이스 에뮬레이션 — 노트북에서 CXL 개발 환경 구축
- 152 Linux CXL 드라이버 분석 — cxl_pci·cxl_core·region·DAX
관련 글
DMA-Friendly Allocator — dma_alloc_coherent·IOMMU·Pool
DMA buffer 할당 패턴을 coherent와 streaming, CMA, IOMMU, MPU non-cacheable 영역으로 나눠 정리합니다.
같은 시리즈에서 이어 읽기
Zero-Copy Pipeline — DMA-BUF·sendfile·io_uring·splice
Camera→GPU→Encoder→Network pipeline에서 memcpy를 모두 제거하는 패턴을 모았습니다.
같은 시리즈에서 이어 읽기
Cache Line 최적화 — Alignment·Prefetch·False Sharing 처리
64-byte line alignment, software prefetch, false sharing 회피, SoA·AoS 선택.
공통 태그 기반 추천
이 글을 참조하는 글 (5)
- False Sharing 해결 — Cache Line Padding·SoA 적용 — Modern Embedded Recipes
- ARM NEON 심화 — Matrix Multiply·FFT·Image Filter 적용 — Modern Embedded Recipes
- SIMD 활용 분석 — Intrinsics·Auto-Vectorization·OpenMP SIMD — Modern Embedded Recipes
- DMA-Friendly Allocator — dma_alloc_coherent·IOMMU·Pool — Modern Embedded Recipes
- 메모리 정렬과 패딩 분석 — Natural·Strict Alignment·Trap — Modern Embedded Recipes