HBM 3D 스택 구조 분해 — TSV·Microbump·Base Die의 역할
#한 줄 요약
“HBM은 DRAM die를 위로 쌓고, TSV로 수직으로 신호를 통과시킵니다.” — 한 stack은 base die 하나 위에 DRAM die 여러 장을 쌓은 구조입니다. die들은 *TSV(Through-Silicon Via)*로 수직 연결되고, base die가 host 칩과 맞닿는 PHY를 담당합니다.
Ch 1에서 HBM이 왜 GDDR과 갈렸는지를 봤습니다. 핵심은 1024-bit 광폭 bus였습니다. 이번 장은 그 1024-bit가 어떻게 한 stack 안에 들어가는지입니다. 물리적으로 어떻게 적층되는지, 전기 신호가 위로 어떻게 통과하는지, 왜 yield가 어려운지까지 봅니다.
#stack 단면
HBM3E 12-Hi stack 한 개를 옆에서 잘라 보면 다음과 같습니다.
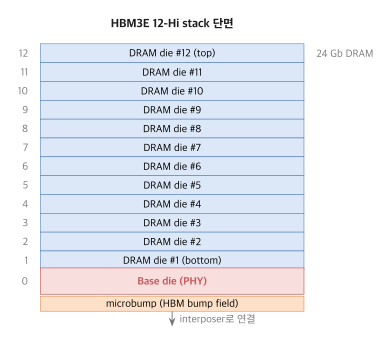
쌓는 die 수는 규격마다 정해져 있습니다. HBM3는 4·8·12-Hi(16-Hi 확장 조항), HBM4는 4·8·12·16-Hi입니다.
stack의 총 높이는 GPU/NPU die와 함께 같은 cold plate에 닿아야 하므로 엄격한 제약입니다. JEDEC 기준 nominal package 높이는 HBM3E까지 720 μm, HBM4 12·16-Hi는 775 μm로 완화됐습니다. SK hynix는 12-Hi HBM3E를 만들면서 DRAM die를 40% 얇게 해 8-Hi 제품과 같은 두께에 12장을 쌓았습니다.
#base die의 역할
stack 맨 아래에 있는 base die는 host 칩(GPU/NPU)과 맞닿는 die입니다. 1024-bit 데이터와 command/address 신호가 base die의 PHY를 거쳐 위의 DRAM die들로 갑니다.
base die를 어떤 공정으로 만드는지는 세대와 회사에 따라 다릅니다. SK hynix는 HBM3E까지 자체 공정으로 base die를 만들었고, HBM4부터 TSMC의 로직 공정으로 넘어갔습니다. base die에 넣는 로직과 제어 기능이 늘면서 로직 공정이 필요해졌기 때문입니다. 2024년 4월 두 회사가 이를 위한 MOU를 맺었습니다.
#TSV — 수직으로 통하는 신호
DRAM die가 12장 쌓여 있는데, 맨 위 die의 신호도 base die까지 수직으로 내려와야 합니다. 이것을 가능하게 하는 게 *TSV(Through-Silicon Via)*입니다.
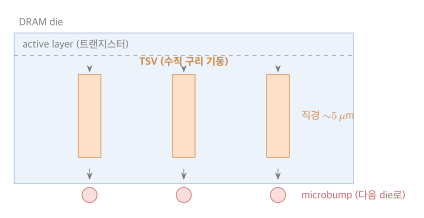
TSV는 실리콘 본체를 관통하는 구리 비아입니다. die 하나 안의 수직 연결을 맡고, die와 die 사이는 microbump가 잇습니다. stack당 TSV 개수와 용도별 분배는 벤더가 공개하지 않습니다.
#microbump — die 간 연결
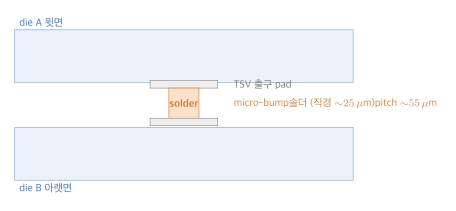
die 사이는 솔더 microbump로 잇고, 그 틈을 underfill로 채웁니다. SK hynix는 이 과정에 *MR-MUF(Mass Reflow Molded Underfill)*를 씁니다.
솔더 없이 구리끼리 직접 붙이는 hybrid bonding은 bump보다 간격을 훨씬 좁힐 수 있어 높은 stack의 후보로 거론됐습니다. 하지만 JEDEC이 HBM4 높이를 775 μm로 완화하면서 16-Hi HBM4도 기존 bonding 기술로 만들 수 있게 됐고, HBM4는 microbump를 유지했습니다.
세대별 microbump pitch와 bump 직경은 벤더 공개 자료에서 확인하지 못했습니다.
#Channel과 Pseudo Channel
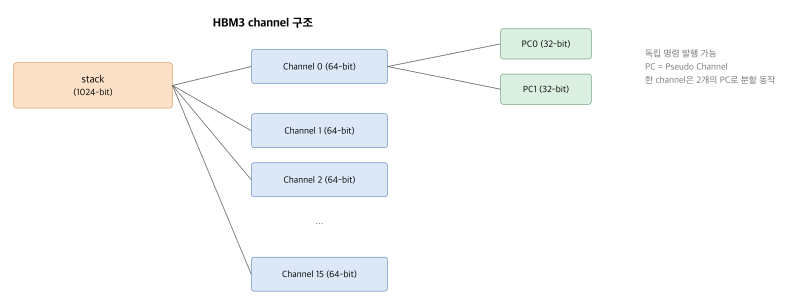
1024-bit bus는 내부적으로 여러 channel로 나뉩니다.
| 세대 | Channel | Pseudo Channel |
|---|---|---|
| HBM2 | 128-bit × 8 | 64-bit × 16 |
| HBM3 | 64-bit × 16 | 32-bit × 32 |
| HBM4 | 64-bit × 32 (2048-bit) | channel당 2개 |
Pseudo Channel은 같은 channel을 둘로 나눠 각자 명령을 실행하게 한 구조입니다. 두 PC는 address·command bus를 공유하지만 명령은 각자 해석합니다. 한쪽 PC가 bank conflict로 멈춘 동안 다른 PC가 일을 계속할 수 있습니다.
#yield — HBM이 어려운 이유
die를 여러 장 쌓으면 한 장만 불량이어도 stack이 불량이 됩니다. 계산을 위해 die 하나의 양품률을 95%로 가정하면 stack 양품률은 0.95^N(N = base + DRAM die 수)입니다.
| stack | N (base+DRAM) | 가정상 yield |
|---|---|---|
| 4-Hi | 5 | 77.4% |
| 8-Hi | 9 | 63.0% |
| 12-Hi | 13 | 51.3% |
| 16-Hi | 17 | 41.8% |
95%는 계산용 가정입니다. 실제로는 die를 쌓기 전에 *양품 die(KGD, Known Good Die)*만 골라내고, 불량 row·column을 redundancy로 대체해 보정합니다. 그래도 쌓는 장수가 늘수록 위험은 거듭제곱으로 커집니다.
HBM 제조 흐름 (개략)
1. DRAM wafer 제조, wafer 단위 test2. 양품 die(KGD) 선별3. base die 제조와 test4. die를 한 층씩 쌓아 TSV·microbump로 접합5. 완성 stack test6. GPU/NPU die와 함께 interposer 위에 패키징완성 stack test에서 불량이 나면 그 stack에 쓴 die 전부를 잃습니다. 그래서 쌓기 전 KGD 선별이 중요합니다.
#자주 하는 실수
#“더 많이 쌓으면 항상 좋다”
12-Hi → 16-Hi는 capacity가 33% 늘지만, 위 가정(die 95%)에서는 stack yield가 51.3%에서 41.8%로 떨어집니다. 쌓는 장수는 용량과 수율·높이 제약의 균형으로 정해집니다.
#base die가 항상 로직 공정이라는 오해
SK hynix는 HBM3E까지 base die를 자체 공정으로 만들었고, HBM4부터 TSMC 로직 공정을 씁니다. 세대와 회사마다 다릅니다.
#“HBM4부터 hybrid bonding을 쓴다”
JEDEC이 HBM4 높이를 775 μm로 완화하면서 HBM4는 microbump를 유지했습니다.
#“HBM stack을 socket에 꽂을 수 있다”
불가능합니다. HBM은 interposer에 영구 접합됩니다. 교체나 upgrade가 안 되고, 불량 stack 하나가 GPU/NPU 패키지 전체를 버리게 만들 수 있습니다. 그래서 쌓기 전 test가 비싸도 필수입니다.
#정리
- HBM stack은 base die 하나 + DRAM die 여러 장(HBM3 4·8·12-Hi, HBM4 최대 16-Hi)의 적층 구조입니다.
- 총 높이는 cold plate에 맞춰진 엄격한 제약입니다. JEDEC nominal은 HBM3E까지 720 μm, HBM4 775 μm입니다.
- base die는 host와 맞닿는 PHY를 담당합니다. SK hynix는 HBM4부터 base die를 TSMC 로직 공정으로 만듭니다.
- TSV는 die 안의 수직 연결, microbump는 die 사이 연결입니다. HBM4도 microbump를 유지했습니다.
- 1024-bit bus는 HBM3에서 64-bit channel 16개, channel마다 32-bit pseudo channel 2개로 나뉩니다.
- yield는 die 수의 거듭제곱으로 떨어지므로 쌓기 전 KGD 선별과 redundancy가 필수입니다.
- HBM stack은 interposer에 영구 접합되어 교체가 불가능합니다.
#다음 편
Ch 3: HBM2/HBM2E/HBM3/HBM3E 스펙 비교에서는 세대별 발전을 bandwidth·capacity·feature 척도로 정리합니다. HBM4의 2048-bit 인터페이스가 왜 필요했는지도 함께 봅니다.
#관련 항목
- Ch 1: 고대역 메모리 개요
- Ch 3: HBM 세대 비교
- Ch 6: 열 설계와 전력 관리
- UCIe Ch 6: 2.5D 패키징 — interposer 공유
- UCIe Ch 7: 3D 패키징 — hybrid bonding 심화
- BoW Ch 6: 패키징 — bump pitch와 yield
HBM·GDDR 심화 · 2 of 12
- 1 HBM과 GDDR 분기점 분석 — Bandwidth·Capacity·Cost 트레이드오프
- 2 HBM 3D 스택 구조 분해 — TSV·Microbump·Base Die의 역할
- 3 HBM2·HBM2E·HBM3·HBM3E 세대 비교 — JEDEC 표준 진화 흐름
- 4 GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로
- 5 메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall
- 6 HBM 열 설계와 전력 관리 — Stack 열 부하·Refresh Cost·냉각 솔루션
- 7 HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling
- 8 NPU·GPU에서의 HBM 활용 — Weight·Activation·KV Cache 배치 분석
- 9 CXL.mem 분석 — HBM·GDDR·DDR 다음의 메모리 계층
- 10 CXL.mem 프로토콜 분해 — 왕복 횟수가 만드는 지연, 링크가 만드는 대역폭
- 11 CXL Type 1·2·3 디바이스 분류 — 이 중 무엇이 나에게 메모리인가
- 12 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일
관련 글
HBM2·HBM2E·HBM3·HBM3E 세대 비교 — JEDEC 표준 진화 흐름
세대별 bandwidth·capacity·signaling — JEDEC 표준의 진화 흐름.
같은 시리즈에서 이어 읽기
GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로
고속 그래픽 메모리 — clock·PAM 신호의 진화로 32 Gbps에 도달한 경로.
같은 시리즈에서 이어 읽기
실전 사례 — CXL.mem 추가로 LLM inference KV cache 처리량 회복
70B 모델 KV cache가 HBM 한계를 넘어 throughput이 무너졌을 때, CXL.mem 256 GB pool 추가로 회복한 실전 케이스.
공통 태그 기반 추천