HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling
#한 줄 요약
“메모리 컨트롤러가 bank parallelism을 얼마나 짜내느냐가 실제 대역폭을 좌우합니다.” — bank·row·column 계층, command scheduling, address mapping, refresh 처리가 모두 컨트롤러의 책임입니다. 같은 HBM stack이라도 컨트롤러가 요청을 어떻게 흩고 묶느냐에 따라 실제로 쓰는 대역폭이 달라집니다.
Ch 6에서 HBM의 전력과 열을 봤습니다. 이번 장은 컨트롤러가 HBM을 어떻게 보는지입니다.
#컨트롤러가 보는 HBM
컨트롤러 입장에서 HBM3 stack 1개는 계층으로 나뉜 주소 공간입니다.
HBM3 stack 주소 계층
stack (1024-bit)└── Channel 0 .. 15 (16 channel, 64-bit) └── Pseudo Channel 0, 1 (32-bit) └── Bank (bank group으로 묶임) └── Row └── Columnchannel 16개와 channel당 pseudo channel 2개는 JEDEC HBM3 발표에 나온 값입니다. pseudo channel 아래의 bank group·bank·row·column 개수와 주소 비트 배치는 JEDEC 규격 원문에 있고, 이 장에서는 TBD로 둡니다.
#DRAM 명령 인터페이스
컨트롤러가 DRAM에 보내는 기본 명령은 DRAM 계열 공통입니다.
DRAM 기본 명령
ACT (Activate) : row를 sense amp에 올림 PRE (Precharge) : row를 닫고 bit line 충전 RD (Read) : 열린 row의 column 읽기 WR (Write) : 열린 row의 column 쓰기 REF (Refresh) : row 데이터 다시 채우기 MRS (Mode Register Set) : 설정 변경명령 사이에는 *최소 간격(timing constraint)*이 있습니다. 대표적인 것이 같은 bank에서 ACT 뒤 RD까지 기다려야 하는 tRCD, PRE 뒤 다음 ACT까지 기다려야 하는 tRP입니다. HBM3의 실제 값은 TBD입니다.
bank group이 있는 DRAM에서는 같은 bank group 안의 연속 column 명령 간격(tCCD_L)이 다른 bank group으로 넘어갈 때(tCCD_S)보다 깁니다. 그래서 컨트롤러는 연속 요청을 bank group을 번갈아 보내 명령 간격을 줄입니다.
#Scheduling — Open vs Closed Page
같은 row를 계속 열어 둘지(Open) *바로 닫을지(Closed)*가 핵심 정책 선택입니다.
Open Page Policy — 같은 row를 열어 두고 여러 column을 연속으로 읽습니다. 다음 요청도 같은 row면(row hit) ACT 없이 바로 RD합니다. 다른 row면(row miss) PRE → ACT를 거쳐야 합니다.
ACT row=RRD col=0RD col=1RD col=2PREACT row=R'- 장점: row hit이 많으면 latency가 짧음
- 단점: row miss면 PRE·ACT 시간이 추가됨
Closed Page Policy — 한 번 읽고 바로 auto-precharge로 닫습니다.
ACT row=R + RD col=0 + auto PREACT row=R + RD col=1 + auto PRE- 장점: row buffer locality가 없을 때 단순함
- 단점: row hit 기회를 버림
많은 컨트롤러가 adaptive 방식을 씁니다. queue에 같은 row로 가는 요청이 더 있으면 열어 두고, 없으면 auto-precharge로 닫습니다.
#Bank parallelism — 인터리브의 핵심
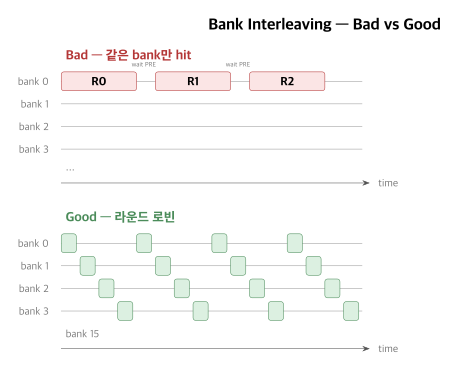
- Bad — 요청이 같은 bank의 다른 row로만 몰리면 매번 PRE·ACT를 기다려야 하고 나머지 bank는 놉니다.
- Good — 요청이 여러 bank로 흩어지면 한 bank가 row를 여는 동안 다른 bank가 데이터를 보냅니다.
이를 가능하게 하려면 address-to-bank mapping이 균등해야 합니다.
#Address mapping — XOR hash
주소의 상위 비트를 그대로 bank 번호로 쓰면, 큰 stride로 도는 access가 한 bank에 몰릴 수 있습니다.
Linear mapping (bank = 상위 비트)
address = 0x0000_0000 → bank 0address = 0x0010_0000 → bank 1...작은 범위를 반복 sweep하면 같은 bank만 hit해결책 중 하나가 XOR hash mapping입니다. 여러 비트 구간을 XOR해 bank 번호를 만들면, stride access도 여러 bank로 흩어집니다.
// 개념 예시 (실제 비트 위치는 컨트롤러마다 다름)uint64_t base = addr >> 5; // burst 단위
int ch = (base >> 4) & 0xF; // channel: 세 구간 XORch ^= (base >> 12) & 0xF;ch ^= (base >> 20) & 0xF;
int bank = (base >> 8) & 0xF; // bank: 두 구간 XORbank ^= (base >> 16) & 0xF;상용 GPU·NPU 컨트롤러의 실제 mapping은 공개되지 않습니다.
#Per-bank refresh — bandwidth 보호
all-bank refresh는 refresh하는 동안 모든 bank를 멈춥니다. per-bank refresh는 한 bank만 refresh하고 나머지 bank는 계속 일하게 합니다.
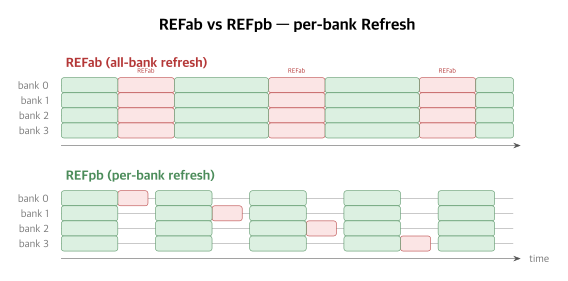
per-bank refresh를 쓰려면 컨트롤러가 bank별 refresh 일정을 추적해야 합니다. HBM 세대별 지원 여부와 refresh 손실 비율은 TBD입니다.
#Read-write turnaround
같은 data bus 위에서 Read 뒤 Write나 Write 뒤 Read로 방향을 바꾸면 turnaround 시간이 듭니다. queue에서 RD와 WR이 섞여 도착해도, 좋은 컨트롤러는 RD끼리, WR끼리 묶어 방향 전환 횟수를 줄입니다.
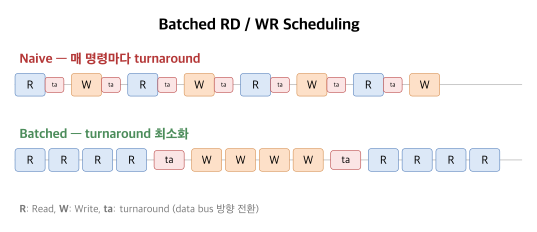
queue가 R W R W R W R W로 도착해도 R R R R / W W W W로 묶으면 turnaround가 여러 번에서 한 번으로 줄어듭니다.
#ECC
HBM3는 DRAM die 안에 *on-die ECC(symbol 기반)*를 표준으로 둡니다. 컨트롤러가 그 위에 별도 ECC를 더하는지는 제품마다 다릅니다.
#Outstanding request queue
컨트롤러는 여러 outstanding request를 동시에 추적해 bank별로 schedule합니다.
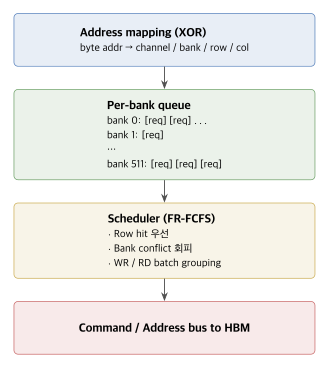
대표적인 scheduling 정책이 *FR-FCFS(First-Ready, First-Come-First-Served)*입니다. 지금 바로 실행할 수 있는 요청(열린 row로 가는 row hit)을 먼저 처리하고, 그중에서는 먼저 온 요청을 먼저 처리합니다.
#FPGA 예 — Xilinx HBM
FPGA에서는 HBM 컨트롤러가 IP로 제공됩니다. AMD(Xilinx) Alveo U55C는 16 GB HBM2에 460 GB/s입니다. AXI HBM Controller IP(PG276)는 programmable logic 쪽에 256-bit AXI 포트 32개를 열어 줍니다. 포트 하나가 pseudo channel 하나에 대응하고, 포트당 이론 대역폭 14.375 GB/s × 32 = 460 GB/s입니다. 포트는 segmented crossbar를 거쳐 어느 stack의 어느 pseudo channel이든 접근할 수 있습니다.
Alveo U55C (16 GB HBM2)
User logic ──► AXI 포트 × 32 (256-bit) │ segmented crossbar ▼ HBM Controller IP │ ▼ pseudo channel × 32 (HBM2 stack 2개)#자주 하는 실수
#“address mapping은 신경 쓸 필요가 없다”
기본 mapping은 일반적인 access에 맞춰져 있습니다. access pattern이 특정 stride에 몰리면 bank conflict가 생길 수 있어, 성능이 이상하면 mapping과 access pattern을 함께 봐야 합니다.
#“open page가 항상 좋다”
random access가 많은 workload에서는 row hit이 드물어 closed page가 낫습니다. 그래서 adaptive 방식이 흔합니다.
#tCCD_L과 tCCD_S를 거꾸로 이해
같은 bank group 안(tCCD_L)이 더 깁니다. 연속 요청은 bank group을 번갈아 보내야 간격이 짧아집니다.
#“Xilinx HBM IP는 AXI-Stream이다”
AXI HBM Controller IP는 memory-mapped AXI 포트 32개를 엽니다. AXI-Stream이 필요하면 사용자 로직에서 따로 감싸야 합니다.
#정리
- HBM3 stack은 컨트롤러에게 16 channel × 2 pseudo channel 아래 bank·row·column 계층으로 보입니다.
- 컨트롤러는 page policy, bank 인터리브, address mapping, refresh 처리, RD/WR 묶기로 실제 대역폭을 끌어올립니다.
- bank group이 있으면 다른 group으로 번갈아 보내야 명령 간격이 짧아집니다.
- FR-FCFS는 row hit을 우선 처리하는 대표 scheduling 정책입니다.
- Xilinx HBM IP는 256-bit memory-mapped AXI 포트 32개로 HBM2 pseudo channel 32개에 접근합니다.
#다음 편
Ch 8: NPU·GPU에서의 활용에서는 LLM weight·activation·KV cache가 HBM을 어떻게 채우는지를 봅니다.
#관련 항목
- Ch 5: 대역폭 계산과 병목 분석
- Ch 6: 열 설계와 전력 관리
- Ch 8: NPU·GPU 활용
- CXL Ch 4: CXL.mem — 외부 메모리 컨트롤러
- BoW Ch 4: BoW Memory — 메모리 트랜잭션의 일반론
HBM·GDDR 심화 · 7 of 12
- 1 HBM과 GDDR 분기점 분석 — Bandwidth·Capacity·Cost 트레이드오프
- 2 HBM 3D 스택 구조 분해 — TSV·Microbump·Base Die의 역할
- 3 HBM2·HBM2E·HBM3·HBM3E 세대 비교 — JEDEC 표준 진화 흐름
- 4 GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로
- 5 메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall
- 6 HBM 열 설계와 전력 관리 — Stack 열 부하·Refresh Cost·냉각 솔루션
- 7 HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling
- 8 NPU·GPU에서의 HBM 활용 — Weight·Activation·KV Cache 배치 분석
- 9 CXL.mem 분석 — HBM·GDDR·DDR 다음의 메모리 계층
- 10 CXL.mem 프로토콜 분해 — 왕복 횟수가 만드는 지연, 링크가 만드는 대역폭
- 11 CXL Type 1·2·3 디바이스 분류 — 이 중 무엇이 나에게 메모리인가
- 12 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일
관련 글
NPU·GPU에서의 HBM 활용 — Weight·Activation·KV Cache 배치 분석
Weight·activation·KV cache — HBM 자리잡기와 시리즈 마무리.
같은 시리즈에서 이어 읽기
CXL.mem 분석 — HBM·GDDR·DDR 다음의 메모리 계층
CXL.mem이 메모리 계층에 끼어드는 자리 — on-package HBM과 DRAM DIMM 사이의 새 tier.
같은 시리즈에서 이어 읽기
실전 사례 — CXL.mem 추가로 LLM inference KV cache 처리량 회복
70B 모델 KV cache가 HBM 한계를 넘어 throughput이 무너졌을 때, CXL.mem 256 GB pool 추가로 회복한 실전 케이스.
공통 태그 기반 추천