메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall
#한 줄 요약
“데이터시트 대역폭은 peak입니다. 실제로 쓰는 대역폭은 그보다 낮습니다.” — refresh·row activation·bank conflict·명령 overhead가 효율을 깎습니다. 그리고 AI workload의 상당수는 연산보다 메모리를 먼저 다 씁니다. V100에서 H100까지 연산 성능은 약 8배, HBM 대역폭은 약 3.7배 늘어 그 간격이 벌어졌습니다. 이것이 memory wall입니다.
Ch 4에서 GDDR signaling의 진화를 봤습니다. 이번 장은 대역폭이 실제로 어떻게 쓰이는지입니다.
#Theoretical BW의 계산
먼저 공칭 대역폭은 단순합니다.
공식: BW = pin_rate × bus_width / 8
HBM3 stack: 6.4 Gbps × 1024-bit / 8 = 819 GB/s
HBM3E stack (9.6 Gbps): 9.6 Gbps × 1024-bit / 8 = 1,229 GB/s ≈ 1.23 TB/s
HBM4 stack (8.0 Gbps × 2048-bit): 8.0 Gbps × 2048-bit / 8 = 2,048 GB/s ≈ 2.0 TB/s
GDDR6X chip (21 Gbps × 32-bit): 21 Gbps × 32-bit / 8 = 84 GB/s
NVIDIA H100 SXM5 (HBM3 5 stack): HBM3 정격으로 돌리면 5 × 819 = 4,096 GB/s 실제 spec: 3.35 TB/sH100의 3.35 TB/s는 HBM3를 정격(6.4 Gbps)보다 낮은 속도로 돌린 peak입니다. 효율 손실을 뺀 값이 아닙니다. 실제 application이 쓰는 대역폭은 이 peak보다 더 낮습니다.
#효율 손실 — 어디로 가는가
peak에서 실제로 쓰는 대역폭까지의 갭은 다음 요인에서 옵니다.
- refresh — refresh 중인 bank는 read·write를 받지 못합니다.
- row activation — 다른 row를 읽으려면 지금 row를 닫고(PRE) 새 row를 열어야(ACT) 합니다.
- bank conflict — 여러 요청이 같은 bank의 다른 row를 노리면 직렬화됩니다.
- command/address overhead — precharge·activate 같은 명령도 command bus를 차지합니다.
각 요인이 몇 %를 깎는지는 메모리 세대, 컨트롤러, access pattern에 따라 달라서 측정으로 확인해야 합니다.
#Row activation latency
DRAM access는 row를 먼저 activate해야 column read/write가 가능합니다.
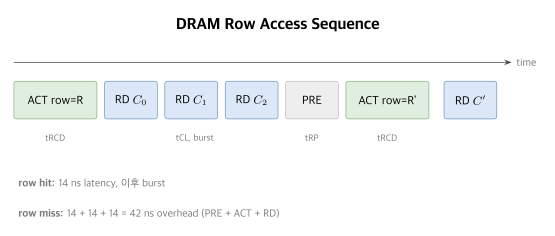
*같은 row 안의 access(row hit)*는 효율적이지만, random access는 row miss가 많아 bandwidth가 깎입니다.
#Bank conflict
여러 outstanding request가 같은 bank를 노리면 직렬화됩니다.
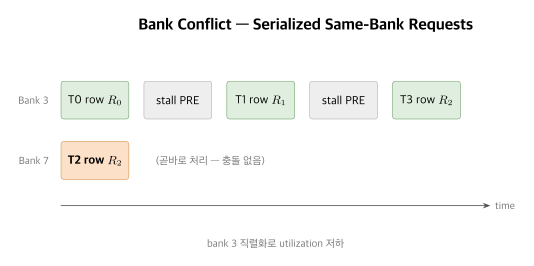
HBM3는 stack당 16 channel에 channel마다 pseudo channel이 2개라, 독립적으로 명령을 받는 단위가 많습니다. 컨트롤러는 address mapping으로 요청을 이 단위들에 고르게 흩어 conflict를 줄입니다.
#Achievable BW의 측정
실제 BW를 측정하는 가장 간단한 방법은 STREAM 벤치마크입니다.
// STREAM Triad: a[i] = b[i] + scalar * c[i]// memory traffic = 3N (2 read, 1 write) × sizeof(double)
#define N (1<<28) // 256M elementsdouble *a, *b, *c;double scalar = 3.0;
cudaMalloc(&a, N * sizeof(double));cudaMalloc(&b, N * sizeof(double));cudaMalloc(&c, N * sizeof(double));
// kernel__global__ void triad(double *a, double *b, double *c, double s, int n) { int i = blockIdx.x * blockDim.x + threadIdx.x; if (i < n) a[i] = b[i] + s * c[i];}
// measure time → BW = 3 * N * 8 / time측정값은 GPU, driver, 메모리 클럭 설정에 따라 달라지므로 자기 환경에서 직접 재야 합니다. STREAM은 순차 access라서 random access가 섞인 실제 workload보다 좋게 나옵니다.
#Roofline 모델
Roofline은 compute와 memory bandwidth의 관계를 한 그림에 보여 줍니다.
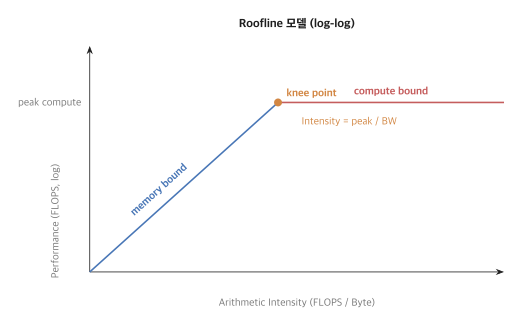
knee = peak_compute / peak_BW. H100 SXM은 FP16 Tensor Core가 1,979 TFLOPS(sparsity 적용), dense로는 그 절반인 약 990 TFLOPS입니다. knee는 990 TFLOPS ÷ 3.35 TB/s ≈ 295 FLOP/Byte입니다.
Arithmetic Intensity는 byte 1개당 몇 FLOP를 하는지입니다. 몇 가지 연산을 직접 계산하면 다음과 같습니다.
| 연산 | 계산 | Intensity (FLOP/Byte) | H100 기준 |
|---|---|---|---|
Vector add (FP32) a[i]=b[i]+c[i] | 1 FLOP / (4 B × 3) | 0.083 | memory bound |
| GEMV, batch 1 (FP16 weight) | 2 FLOP / 2 B per weight | 약 1 | memory bound |
| GEMM N×N×N (FP16, 이상적 재사용) | 2N³ / (3N² × 2 B) = N/3 | N=1024: 341, N=16384: 5,461 | knee 위 |
LLM decode의 batch 1 연산은 GEMV에 가까워 intensity가 1 근처입니다. knee(295)보다 한참 아래라 memory bound입니다. batch를 B로 키우면 같은 weight로 B개 토큰을 계산하므로 intensity가 대략 B배 됩니다.
#Memory wall
compute와 memory BW의 증가 속도 차이가 벌어지고 있습니다.
| GPU | 출시 | FP16 Tensor (dense) | HBM BW | knee (FLOP/B) |
|---|---|---|---|---|
| V100 | 2017 | 125 TFLOPS | 900 GB/s | 139 |
| H100 SXM | 2022 | 약 990 TFLOPS | 3.35 TB/s | 295 |
| 배율 | 약 7.9배 | 약 3.7배 | 약 2.1배 |
knee가 오른쪽으로 이동하면 같은 workload라도 memory bound 쪽으로 밀립니다.
해결 방향은 세 갈래입니다.
- on-chip cache 늘리기 — H100의 L2는 50 MB입니다. 그래도 LLM weight 수십~수백 GB에는 턱없이 부족합니다.
- HBM 세대 진화 — HBM3E(stack당 1.23 TB/s) → HBM4(최대 2 TB/s).
- 알고리즘 측에서 intensity 올리기 — batch 키우기, FlashAttention처럼 tile로 HBM 왕복 줄이기.
#LLM inference의 MBU
LLM 추론에서는 *Memory Bandwidth Utilization(MBU)*을 함께 봅니다. 추론은 두 단계로 나뉩니다.
- Prefill (prompt encoding) — prompt 토큰을 한꺼번에 처리하므로 weight 재사용이 커 compute bound에 가깝습니다.
- Decode (token by token) — 매 토큰마다 weight를 다시 읽고, sequence 길이에 비례해 KV cache를 추가로 읽습니다. memory bound입니다.
MBU = actual BW used / peak BWMFU = actual FLOPS / peak FLOPS
Llama 2 70B (FP16) decode, batch 1, H100 SXM: weight 140 GB를 한 번 읽는 시간 하한 = 140 GB / 3.35 TB/s ≈ 42 ms/tokenbatch 1 decode는 토큰 하나에 최소 42 ms가 걸리고, 그동안 계산 유닛은 대부분 놉니다. batch를 키우면 같은 weight read로 여러 토큰을 만들어 MFU가 올라가지만, 토큰 하나의 latency는 줄지 않습니다.
#측정 도구
GPU에서 어디가 병목인지 보는 도구가 있습니다.
# NVIDIA — Nsight Compute (kernel profiling)ncu --set full ./inference# 보고서의 "Memory Workload Analysis" 섹션에서 DRAM throughput, L2 hit rate
# AMD — ROCm Profilerrocprof --hsa-trace --hip-trace ./inference
# Linux generic — perf (CPU 쪽 cache)perf stat -e cache-references,cache-misses,LLC-load-misses ./app데이터센터에서는 *DCGM(NVIDIA Data Center GPU Manager)*으로 GPU 여러 장의 메모리 사용률을 함께 봅니다.
# DCGM field: 204 = DCGM_FI_DEV_MEM_COPY_UTIL,# 1005 = DCGM_FI_PROF_DRAM_ACTIVE,# 1008 = DCGM_FI_PROF_PIPE_FP16_ACTIVEdcgmi dmon -e 204,1005,1008#자주 하는 실수
#“spec BW를 그대로 capacity planning에 쓴다”
데이터시트 대역폭은 peak입니다. 실제 workload에서 나오는 값은 직접 측정해서 planning에 써야 합니다.
#“BW가 부족하니 더 빠른 chip을 쓴다”
profiling 없이 BW upgrade만 하면 효과가 없을 수 있습니다. compute bound 단계에서는 BW를 늘려도 throughput이 안 늘어납니다. Nsight Compute로 어느 단계가 어느 쪽에 막히는지 먼저 봐야 합니다.
#“STREAM이 충분한 벤치마크다”
STREAM은 순차 access입니다. 실제 LLM은 KV cache 접근이 섞입니다. 효율 측정은 대표 workload로 해야 합니다. MLPerf Inference가 그런 기준입니다.
#“MFU만 보면 시스템 효율을 안다”
MFU만 보면 compute 사용률은 알지만 memory 사용률은 모릅니다. MBU와 함께 봐야 진짜 병목이 보입니다. MFU가 낮고 MBU가 높으면 memory bound, MFU가 높고 MBU가 낮으면 compute bound입니다.
#bank conflict를 컨트롤러 책임으로만 가정
컨트롤러가 잘 해도 application의 access pattern이 나쁘면 conflict가 쌓입니다. CUDA의 coalesced access 같은 software 쪽 최적화가 함께 필요합니다.
#정리
- 공칭 대역폭은
pin rate × bus width ÷ 8이고, H100의 3.35 TB/s도 peak입니다. - 실제 대역폭은 refresh·row activation·bank conflict·명령 overhead로 깎이며, 정도는 측정으로 확인합니다.
- Roofline에서 H100의 knee는 약 295 FLOP/Byte입니다. batch 1 LLM decode는 intensity가 약 1이라 강한 memory bound입니다.
- V100 → H100에서 연산은 약 7.9배, 대역폭은 약 3.7배 늘어 knee가 약 2배 오른쪽으로 갔습니다.
- batch 1 decode는 Llama 2 70B에서 토큰당 최소 42 ms입니다.
- 측정은 Nsight Compute, rocprof, DCGM으로 합니다.
#다음 편
Ch 6: 열 설계와 전력 관리에서는 HBM stack의 열 구조, 온도와 refresh의 관계, 냉각 방식과 thermal throttling을 봅니다.
#관련 항목
- Ch 3: HBM 세대 비교
- Ch 6: 열 설계와 전력 관리
- Ch 8: NPU·GPU 활용
- CXL Ch 8: ML 가속기 — memory wall 보완 경로
HBM·GDDR 심화 · 5 of 12
- 1 HBM과 GDDR 분기점 분석 — Bandwidth·Capacity·Cost 트레이드오프
- 2 HBM 3D 스택 구조 분해 — TSV·Microbump·Base Die의 역할
- 3 HBM2·HBM2E·HBM3·HBM3E 세대 비교 — JEDEC 표준 진화 흐름
- 4 GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로
- 5 메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall
- 6 HBM 열 설계와 전력 관리 — Stack 열 부하·Refresh Cost·냉각 솔루션
- 7 HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling
- 8 NPU·GPU에서의 HBM 활용 — Weight·Activation·KV Cache 배치 분석
- 9 CXL.mem 분석 — HBM·GDDR·DDR 다음의 메모리 계층
- 10 CXL.mem 프로토콜 분해 — 왕복 횟수가 만드는 지연, 링크가 만드는 대역폭
- 11 CXL Type 1·2·3 디바이스 분류 — 이 중 무엇이 나에게 메모리인가
- 12 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일
관련 글
HBM 열 설계와 전력 관리 — Stack 열 부하·Refresh Cost·냉각 솔루션
HBM stack의 전압·열 구조, 온도와 refresh, 냉각 방식과 thermal throttling.
같은 시리즈에서 이어 읽기
HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling
Bank·row·column·command — 컨트롤러가 보는 HBM과 scheduling·address mapping.
같은 시리즈에서 이어 읽기
메모리 대역폭 분석 — STREAM·Roofline·Bus Saturation 측정
STREAM benchmark (Copy·Scale·Add·Triad). Roofline. PMU BUS_ACCESS · DDR bandwidth.
공통 태그 기반 추천
이 글을 참조하는 글 (7)
- 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일 — HBM·GDDR 심화
- CXL.mem 분석 — HBM·GDDR·DDR 다음의 메모리 계층 — HBM·GDDR 심화
- NPU·GPU에서의 HBM 활용 — Weight·Activation·KV Cache 배치 분석 — HBM·GDDR 심화
- HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling — HBM·GDDR 심화
- HBM 열 설계와 전력 관리 — Stack 열 부하·Refresh Cost·냉각 솔루션 — HBM·GDDR 심화
- GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로 — HBM·GDDR 심화
- HBM2·HBM2E·HBM3·HBM3E 세대 비교 — JEDEC 표준 진화 흐름 — HBM·GDDR 심화