NPU·GPU에서의 HBM 활용 — Weight·Activation·KV Cache 배치 분석
#한 줄 요약
“LLM inference의 HBM 점유는 weight·activation·KV cache 세 부분으로 갈립니다.” — Llama 2 70B는 weight만 140 GB이고, KV cache는 batch와 sequence 길이에 정비례해 batch 128에서 seq 2048이면 86 GB, 4096이면 172 GB가 됩니다. 길게 쓸수록 KV cache가 weight를 넘어서는 것이 메모리 폭증의 원인입니다. 뒤에서 카드급 사례와 CXL·UALink와의 결합도 봅니다.
Ch 7에서 컨트롤러의 내부를 봤습니다. 이번 장은 AI workload가 HBM을 어떻게 채우는지입니다. AI 가속기 사례와 HBM 너머의 메모리 tiering까지 정리합니다.
#LLM inference의 메모리 분해
Llama 2 70B 모델을 batch 128, sequence 2048로 서빙한다고 합시다. 이 모델은 layer 80개, hidden 8192, attention head 64개에 KV head는 8개(GQA, grouped-query attention)입니다.
Llama 2 70B inference (FP16, batch 128, seq 2048)
Weight (정적, 모델 자체): 70 B parameter × 2 byte = 140 GB
Activation (decode 한 step): layer 1개: hidden 8192 × batch 128 × 2 byte = 2.1 MB 80 layer 분량을 모두 잡아도 168 MB
KV cache (sequence에 비례): per token: 2 (K, V) × layer 80 × KV head 8 × head_dim 128 × 2 byte = 327,680 byte (약 0.33 MB) batch 128 × seq 2048 × 327,680 byte = 약 86 GB
총 메모리: 140 + 0.17 + 86 = 약 226 GBseq 2048에서는 KV cache(86 GB)가 weight(140 GB)보다 작습니다. 하지만 KV cache는 sequence에 정비례합니다. Llama 2의 최대 길이인 4096으로 늘리면 172 GB가 되어 weight를 넘습니다. GQA가 없었다면, 곧 KV head가 attention head와 같은 64개였다면 seq 2048에서도 8배인 687 GB였을 것입니다. GQA가 줄이려는 것이 바로 이 메모리입니다.
| 가속기 | HBM capacity | weight 140 GB를 넣고 남는 용량 |
|---|---|---|
| NVIDIA H100 SXM | 80 GB | 부족 (weight도 단독으로 안 들어감) |
| NVIDIA H200 | 141 GB | 약 1 GB |
| NVIDIA B200 | 180 GB | 약 40 GB |
| AMD MI300X | 192 GB | 약 52 GB |
| AMD MI325X | 256 GB | 약 116 GB |
H100 80 GB 한 장에는 weight조차 들어가지 않아 최소 2장으로 나눠야 합니다. H200은 weight는 들어가지만 KV cache 자리가 거의 없습니다. batch 128·seq 2048의 KV cache 86 GB까지 한 장에 다 넣을 수 있는 것은 위 표에서 MI325X뿐입니다.
#Weight 저장
weight는 학습 후 정적이고 모든 추론에서 그대로 읽힙니다.
같은 weight를 토큰마다 다시 읽는다는 점이 decode가 메모리 대역폭을 많이 쓰는 이유입니다. layer 하나의 weight는 평균 140 GB ÷ 80 = 1.75 GB입니다.
#Activation — batch와 sequence
activation은 forward pass 중 layer 입출력입니다. batch와 sequence가 곱입니다.
Activation memory
| 단계 | Shape | Size per layer | 비고 |
|---|---|---|---|
| Prefill (입력 prompt encoding) | (batch × seq_in × hidden) = (128 × 2048 × 8192) | 128 × 2048 × 8192 × 2 B = 4 GB | layer마다 reuse 가능 → peak ≈ 2 × max(layer_input, layer_output) ≈ 8 GB |
| Decode (토큰 하나씩) | (batch × 1 × hidden) = (128 × 1 × 8192) | 128 × 8192 × 2 B = 2 MB | 매우 작음 |
activation memory 자체는 KV cache에 비하면 작습니다.
#KV cache — 메모리 폭증의 원인
attention 연산은 과거 모든 토큰의 K, V를 현재 query가 참조합니다. 이것을 재계산 안 하려고 KV cache에 저장합니다.
KV cache size
| 단위 | Attention | K | V | total |
|---|---|---|---|---|
| per layer per token | Vanilla MHA (KV head 64) | 16.4 KB | 16.4 KB | 32.8 KB |
| per layer per token | GQA (KV head 8) | 2.0 KB | 2.0 KB | 4.1 KB |
| per token (80 layer) | Vanilla MHA | — | — | 2.6 MB |
| per token (80 layer) | GQA | — | — | 0.33 MB |
| batch 128 × seq 2048 | Vanilla MHA | — | — | 687 GB |
| batch 128 × seq 2048 | GQA | — | — | 86 GB |
GQA가 KV cache를 8배 줄였습니다. Llama 2는 70B를 포함한 큰 모델에 GQA를 썼습니다.
KV cache access pattern — decode 단계의 매 토큰
for layer in 80: Q = compute(activation) K, V = compute(activation) # new token push
# read past K, V for attention for past_token in past_tokens: attention += Q @ K[past_token].T
# weighted sum with V output = sum(attention * V[past_token])Memory traffic per layer per token
| 종류 | 크기 |
|---|---|
| Weight read | 약 1.75 GB (140 GB ÷ 80 layer) |
| KV cache read | batch × past_len × 4.1 KB (GQA) |
Sequence가 길어질수록 KV traffic이 증가 → long context inference는 KV bound.
batch 128 기준으로 계산하면, 8K context에서 layer당 KV read는 128 × 8192 × 4.1 KB ≈ 4.3 GB로 weight(1.75 GB)의 약 2.5배입니다. 128K context에서는 약 39배입니다.
#Memory layout — tiling 전략
GPU/NPU kernel은 HBM access pattern을 명시적으로 tiling합니다.
// CUDA matmul tiling 의사 코드__global__ void matmul_tiled( half *A, // M × K, in HBM half *B, // K × N, in HBM half *C, // M × N, in HBM int M, int N, int K) { // 1. block-level tile __shared__ half tileA[128][32]; __shared__ half tileB[32][128];
int row = blockIdx.y * 128 + threadIdx.y; int col = blockIdx.x * 128 + threadIdx.x;
float sum = 0;
// 2. tile loop for (int t = 0; t < K; t += 32) { // load tile A from HBM → shared tileA[threadIdx.y][threadIdx.x] = A[row * K + t + threadIdx.x]; // load tile B from HBM → shared tileB[threadIdx.y][threadIdx.x] = B[(t + threadIdx.y) * N + col]; __syncthreads();
// compute on shared (fast) for (int k = 0; k < 32; k++) { sum += tileA[threadIdx.y][k] * tileB[k][threadIdx.x]; } __syncthreads(); }
C[row * N + col] = sum;}핵심은 shared memory(on-chip)에 tile 단위로 load하고 재사용해 HBM access를 최소화하는 것입니다.
tile size 선택
tile 2 KB (32×32 half): - shared memory 사용: 작음 - 같은 데이터를 HBM에서 더 자주 다시 읽음
tile 16 KB (128×64 half): - shared memory 사용: 큼 - HBM에서 다시 읽는 횟수가 줄어듦
H100 shared memory: SM당 최대 228 KBFlashAttention은 attention 계산 자체를 tile로 나눠 HBM과 on-chip SRAM 사이의 읽기·쓰기 횟수를 줄입니다. 중간 결과인 attention 행렬을 HBM에 통째로 쓰지 않는 것이 핵심입니다.
#Decode는 왜 batch를 키우는가
decode는 토큰 하나를 만들 때마다 weight 전체를 한 번 읽습니다. H100 SXM의 HBM 대역폭 3.35 TB/s로 weight 140 GB를 한 번 읽는 데 약 42 ms가 걸립니다(대역폭만 따진 하한값입니다. 실제로는 weight가 80 GB에 다 들어가지 않아 여러 장에 나눠 담습니다).
이 42 ms는 batch 전체가 나눠 씁니다. batch 1이면 토큰 하나에 42 ms, batch 64면 같은 weight read 한 번으로 64개 토큰을 만들어 토큰당 0.65 ms입니다. batch를 키울수록 weight read가 amortize되고, 결국 계산량이나 KV cache 용량이 다음 한계가 됩니다.
#카드급 사례
AI 가속기 카드의 HBM 구성입니다. stack 구성은 벤더가 공개한 경우만 적었습니다.
| 카드 | HBM | stack 구성 | capacity | spec BW | TDP |
|---|---|---|---|---|---|
| NVIDIA H100 SXM5 | HBM3 | 5 stack | 80 GB | 3.35 TB/s | 최대 700 W |
| NVIDIA H200 SXM | HBM3e | — | 141 GB | 4.8 TB/s | 최대 700 W |
| NVIDIA B200 | HBM3e | — | 180 GB | 8 TB/s | TBD |
| NVIDIA B300 (Blackwell Ultra) | HBM3e | — | TBD | TBD | TBD |
| AMD Instinct MI300X | HBM3 | — | 192 GB | 5.3 TB/s | 750 W |
| AMD Instinct MI325X | HBM3E | — | 256 GB | 6 TB/s | 1000 W (peak) |
| Google TPU v5p | HBM | — | 95 GiB | 2,765 GB/s | — |
B200 capacity는 DGX B200(8 GPU, 1,440 GB) 기준입니다.
한국 NPU의 경우입니다.
| 칩 | 메모리 | capacity | 특징 |
|---|---|---|---|
| Rebellions REBEL-Quad (Hot Chips 2025) | HBM3E, 4.8 TB/s (4-chiplet, UCIe) | 144 GB | 1,024 TFLOPS FP16, 최대 600 W |
| Sapeon X330 | TBD | TBD | TBD. Sapeon은 2024년 12월 Rebellions와 합병 |
| Samsung Mach-1 | LPDDR (HBM 아님) | — | HBM 대신 저전력 메모리로 LLM 추론을 겨냥한 칩 (2024년 3월 발표) |
#CXL과의 결합 — Memory Tiering
카드 한 장의 HBM만으로는 큰 모델의 weight와 긴 context의 KV cache를 다 담기 어렵습니다. CXL이 HBM 아래 낮은 tier의 메모리를 제공합니다.
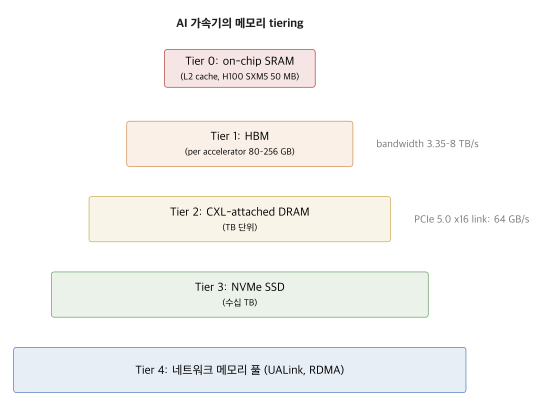
tier를 나눈다면 데이터를 이렇게 대응시킬 수 있습니다.
- hot KV cache → HBM
- warm KV cache → CXL
- cold KV cache → SSD
- weight (정적) → HBM (전부 캐시)
vLLM의 PagedAttention은 tier 분산이 아니라 GPU 메모리 안의 KV cache 관리 기법입니다. KV cache를 OS의 page처럼 블록 단위로 나눠 낭비를 거의 0으로 줄이고, 요청 사이에 KV cache를 공유합니다.
#UALink — GPU 간 메모리 공유
여러 가속기가 서로의 메모리를 직접 access하도록 잇는 open 표준이 UALink입니다. UALink Consortium은 2024년 10월 법인으로 설립됐고, 2025년 4월 8일 UALink 200G 1.0 spec을 비준했습니다.
| 항목 | NVLink (NVIDIA) | UALink 200G 1.0 (open consortium) |
|---|---|---|
| 신호 속도 | — | 200G per lane |
| GPU 당 집계 BW | B200 1.8 TB/s | TBD |
| Fabric 규모 | NVLink switch 기반 | pod당 가속기 최대 1,024개 |
UALink Consortium 이사회: Alibaba, AMD, Apple, Astera Labs, AWS, Cisco, Google, HPE, Intel, Meta, Microsoft, Synopsys.
#Ch 1~8 정리
HBM·GDDR 부분인 Ch 1~8을 한 줄씩 정리합니다. Ch 9부터는 HBM 너머의 메모리인 CXL.mem으로 넘어갑니다.
| Ch | 주제 | 핵심 |
|---|---|---|
| 1 | HBM과 GDDR 분기 | bus width vs pin rate |
| 2 | HBM 스택 구조 | base die + DRAM die × N + TSV |
| 3 | 세대 비교 | HBM2 → HBM3E → HBM4 |
| 4 | GDDR 진화 | NRZ → PAM4 → PAM3 |
| 5 | 대역폭 병목 | sustained BW, roofline, memory wall |
| 6 | 열·전력 | refresh, liquid cooling |
| 7 | 메모리 컨트롤러 | bank scheduling, address mapping |
| 8 | NPU·GPU 활용 | weight, KV cache, tiering |
#자주 하는 실수
#“HBM capacity로 모든 LLM이 수용된다”
70B 모델 weight 140 GB는 H200(141 GB)에 겨우 들어갑니다. batch 128·seq 2048의 KV cache 86 GB까지 합치면 H200 한 장으로는 담을 수 없어 여러 장으로 나눠야 합니다. 카드 capacity만 보고 수용 가능을 판단하면 오답입니다.
#KV cache를 작다고 가정
GQA로 8분의 1로 줄여도 batch 128·seq 2048에서 86 GB, seq 4096이면 172 GB입니다. KV cache는 batch와 sequence에 정비례합니다.
#“batch 1 decode는 GPU 계산력을 다 쓴다”
decode는 토큰마다 weight 전체를 읽어야 하므로, batch 1에서는 weight read 시간이 토큰 생성 시간을 정합니다. 계산 유닛은 그동안 대부분 놉니다. batch를 키워야 같은 weight read로 여러 토큰을 만들 수 있습니다.
#정리
- LLM inference 메모리는 weight·activation·KV cache로 갈리고, 긴 context에서는 KV cache가 가장 크게 늘어납니다.
- Llama 2 70B FP16 weight는 140 GB, KV cache는 batch 128·seq 2048에서 86 GB(GQA)입니다. GQA가 없었다면 687 GB였습니다.
- tile 단위 access로 HBM 재읽기를 줄이는 것이 kernel 효율의 핵심입니다. FlashAttention은 attention 자체를 tile로 나눕니다.
- decode는 토큰마다 weight 전체를 읽습니다. batch를 키우면 그 read가 여러 토큰에 amortize됩니다.
- 카드 capacity는 H100(80 GB) → H200(141 GB) → B200(180 GB) → MI325X(256 GB) 순으로 늘었습니다.
- CXL은 HBM 아래 tier의 메모리, UALink는 가속기 간 메모리 접근을 위한 open 표준입니다.
- 한국 NPU도 메모리 선택이 갈립니다. REBEL-Quad는 HBM3E, Samsung Mach-1은 LPDDR입니다.
#다음 편
Ch 9: CXL.mem 분석에서 HBM·GDDR·DDR 다음의 메모리 계층인 CXL.mem을 봅니다.
#관련 항목
- Ch 1: 고대역 메모리 개요
- Ch 5: 대역폭 계산과 병목 분석
- Ch 7: 메모리 컨트롤러 인터페이스
- CXL Ch 8: ML 가속기 — HBM과 CXL의 조합
- UCIe Ch 12: case studies — 칩렛 + HBM 실제 사례
HBM·GDDR 심화 · 8 of 12
- 1 HBM과 GDDR 분기점 분석 — Bandwidth·Capacity·Cost 트레이드오프
- 2 HBM 3D 스택 구조 분해 — TSV·Microbump·Base Die의 역할
- 3 HBM2·HBM2E·HBM3·HBM3E 세대 비교 — JEDEC 표준 진화 흐름
- 4 GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로
- 5 메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall
- 6 HBM 열 설계와 전력 관리 — Stack 열 부하·Refresh Cost·냉각 솔루션
- 7 HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling
- 8 NPU·GPU에서의 HBM 활용 — Weight·Activation·KV Cache 배치 분석
- 9 CXL.mem 분석 — HBM·GDDR·DDR 다음의 메모리 계층
- 10 CXL.mem 프로토콜 분해 — 왕복 횟수가 만드는 지연, 링크가 만드는 대역폭
- 11 CXL Type 1·2·3 디바이스 분류 — 이 중 무엇이 나에게 메모리인가
- 12 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일
관련 글
CXL.mem 분석 — HBM·GDDR·DDR 다음의 메모리 계층
CXL.mem이 메모리 계층에 끼어드는 자리 — on-package HBM과 DRAM DIMM 사이의 새 tier.
같은 시리즈에서 이어 읽기
CXL.mem 프로토콜 분해 — 왕복 횟수가 만드는 지연, 링크가 만드는 대역폭
Ch 9의 지연·대역폭 수치가 왜 그렇게 나오는지 — 왕복 횟수로 본 지연 예산, 링크에 묶인 대역폭, credit 고갈이 만드는 throughput 절벽, interleave granularity의 유불리.
같은 시리즈에서 이어 읽기
NVIDIA Nsight Systems — GPU·NPU 포함 시스템 분석
NVIDIA Nsight Systems로 CPU·GPU·메모리 통합 timeline 분석. Jetson 임베디드 활용.
공통 태그 기반 추천
이 글을 참조하는 글 (7)
- 실전 사례 — CXL.mem 추가로 LLM inference KV cache 처리량 회복 — Embedded Performance Engineering
- CXL.mem 지연·대역폭 실측 — Direct·Switch·Pooled 토폴로지 비교 — Embedded Performance Engineering
- Ch 15: RAS·Performance·Compliance — 운용·검증의 마지막 단계 — CXL 4.0 Internals
- 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일 — HBM·GDDR 심화
- CXL.mem 분석 — HBM·GDDR·DDR 다음의 메모리 계층 — HBM·GDDR 심화
- HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling — HBM·GDDR 심화
- 메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall — HBM·GDDR 심화