GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로
#한 줄 요약
“GDDR은 signaling을 바꿔 pin rate를 NRZ → PAM4 → PAM3으로 끌어올렸습니다.” — GDDR6은 NRZ로 최대 16 Gbps(JEDEC), GDDR6X는 PAM4로 21 Gbps(Micron), GDDR7은 PAM3로 최대 48 Gbps(JEDEC)입니다. *chip당 bus width(32-bit)*는 그대로 두고 pin rate를 올린 경로입니다.
Ch 3에서 HBM이 *광폭 bus(1024-bit)*로 낮은 pin rate로 가는 길을 봤습니다. GDDR은 반대 방향입니다. bus는 chip당 32-bit로 두고 pin rate를 끌어올립니다. signaling이 같이 진화했기 때문에 가능했습니다.
#한눈에 보는 표
| 세대 | 기준 | per-pin | Signaling | Chip BW (× 32-bit) | 예 |
|---|---|---|---|---|---|
| GDDR6 | JESD250 (2017) | 최대 16 Gbps | NRZ | 64 GB/s | NVIDIA L4·L40 |
| GDDR6X | Micron | 21 Gbps | PAM4 | 84 GB/s | RTX 4090 |
| GDDR7 | JESD239 (2024) | 최대 48 Gbps | PAM3 | 최대 192 GB/s | RTX 5090 |
chip BW는 per-pin × 32 ÷ 8입니다. GDDR7의 192 GB/s는 JEDEC이 밝힌 chip당 최대값입니다.
#GDDR chip의 기본 구조
GDDR chip 한 개는 32-bit 데이터 인터페이스를 가집니다.
| chip 사양 | GDDR6 (JESD250) |
|---|---|
| die 용량 | 8~16 Gb |
| 구성 | x16 dual channel (2 channel × 16-bit = 32-bit) |
| pin rate | 최대 16 Gbps |
| BW per chip | 최대 64 GB/s |
| 동작 전압 | 1.35 V |
| 패키지 | TBD |
GPU에 여러 chip을 병렬로 붙여 총 bus width를 만듭니다.
RTX 4090 메모리 구성 (GDDR6X)
GPU (AD102 die)├── 32-bit memory controller × 12└── 각 controller에 GDDR6X chip 1개
12 chip × 32-bit = 384-bit bus21 Gbps × 384-bit ÷ 8 = 1,008 GB/s24 GB capacitybus가 384-bit까지 늘어나면 chip 12개로 가는 배선을 PCB 위에서 길이를 맞춰 깔아야 합니다.
#NRZ — GDDR6까지
GDDR6은 *NRZ(Non-Return to Zero)*입니다. 한 *Unit Interval(UI)*에 0 또는 1, 곧 1 bit를 보냅니다. 16 Gbps NRZ는 초당 16 G UI입니다.
장점은 단순함입니다. 수신단이 임계전압 1개만 보면 됩니다. 단점은 속도를 두 배로 하려면 UI도 절반으로 줄여야 한다는 것입니다.
#PAM4 — GDDR6X의 4-level
NVIDIA와 Micron이 함께 개발한 GDDR6X는 PAM4를 썼습니다. 한 UI에 4 레벨, 곧 2 bit를 싣습니다.
NRZ·PAM4·PAM3 세 가지 signaling을 같은 시간축으로 비교하면 다음과 같습니다.
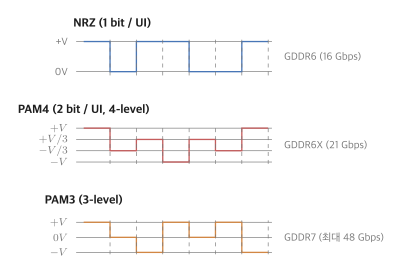
PAM4는 UI당 2 bit라서, 21 Gbps를 내려면 symbol rate는 10.5 Gbaud면 됩니다. 같은 데이터 속도의 NRZ보다 UI가 두 배 깁니다. 대신 같은 전압 폭 안에 레벨을 4개 넣으므로 인접 레벨 사이 간격이 NRZ의 1/3로 좁아집니다.
PAM4 eye diagram의 구조 (이론):
| 레벨 | 의미 | 인접 eye |
|---|---|---|
| 3 | 11 | eye 1 (top, 레벨 3 ↔ 2) |
| 2 | 10 | eye 2 (mid, 레벨 2 ↔ 1) |
| 1 | 01 | eye 3 (bottom, 레벨 1 ↔ 0) |
| 0 | 00 | — |
eye 높이가 1/3이므로 신호 진폭 기준으로 20·log₁₀(1/3) ≈ −9.5 dB만큼 SNR이 불리합니다.
#PAM3 — GDDR7의 절충
GDDR7은 PAM3입니다. 4-level이 아닌 3-level을 씁니다. JEDEC은 PAM3이 고속에서 SNR을 개선하고 에너지 효율을 높인다고 설명합니다.
3-level 한 UI에 실을 수 있는 정보는 이론상 log₂3 ≈ 1.58 bit입니다. 레벨 간격은 전압 폭의 1/2로 PAM4의 1/3보다 50% 넓습니다.
NRZ 대비 eye 높이와 SNR (신호 진폭 기준)
NRZ : 1 → 0 dBPAM3 : 1/2 → −6.0 dBPAM4 : 1/3 → −9.5 dB
UI당 bit (이론 최대):NRZ : 1.0PAM3 : log₂3 ≈ 1.58PAM4 : 2.0JEDEC JESD239(2024년 3월 5일) GDDR7의 주요 내용입니다.
GDDR7 (JESD239)├── signaling : PAM3├── chip BW : 최대 192 GB/s (GDDR6의 2배)├── 독립 channel : 4 (GDDR6의 2에서 두 배)├── density : 16~32 Gbit└── RAS : on-die ECC(ODECC) 실시간 보고, data poison, error check & scrub, command·address parityNVIDIA GeForce RTX 5090은 32 GB GDDR7을 512-bit(32-bit chip 16개)로 붙입니다.
#PCB 라우팅
GDDR chip은 GPU 주변 PCB 위에 놓이고, 모든 데이터 신호가 같은 시간에 도착하도록 trace 길이를 맞춥니다.
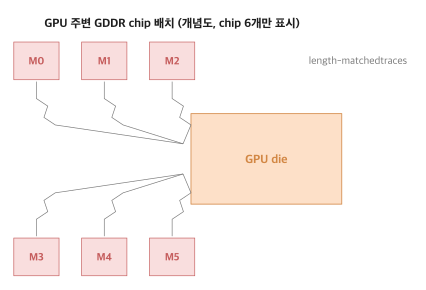
PAM4 21 Gbps의 UI는 1 ÷ 10.5 Gbaud ≈ 95 ps입니다. 같은 데이터 속도를 NRZ로 내면 UI가 약 48 ps라, PAM4는 UI 폭에서 여유를 얻고 레벨 간격에서 여유를 잃는 셈입니다. HBM은 PCB가 아니라 interposer 위 배선으로 같은 문제를 풉니다.
#DRAM 명령 인터페이스
GDDR6 chip은 x16 dual channel입니다. 32-bit를 16-bit channel 두 개로 나눠 각각 독립적으로 명령을 받습니다.
GDDR6 (x16 dual channel)
DQ[15:0] ─ Data (channel A)DQ[31:16] ─ Data (channel B)
명령 종류 (DRAM 공통):- ACT (activate row)- RD (read column)- WR (write column)- PRE (precharge bank)- REF (refresh)GDDR6의 독립 channel은 chip당 2개, GDDR7은 4개입니다. HBM3는 stack당 16 channel(채널당 64-bit)이라 channel-level parallelism이 훨씬 많습니다.
#신뢰성 기능
| 세대 | ECC |
|---|---|
| GDDR6 | TBD |
| GDDR6X | TBD |
| GDDR7 | on-die ECC(ODECC) 표준, 실시간 오류 보고 |
GDDR7부터 on-die ECC와 data poison, error check & scrub 같은 RAS 기능이 JEDEC 표준에 들어갔습니다.
#자주 하는 실수
#“PAM4는 NRZ보다 무조건 빠르다”
PAM4는 같은 symbol rate에서 2배의 데이터를 보냅니다. 하지만 레벨 간격이 1/3로 좁아 SNR이 9.5 dB 불리합니다. 신호 경로가 그만큼 깨끗하지 않으면 속도를 낼 수 없습니다.
#“PAM4 21 Gbps는 NRZ 42 Gbps와 같다”
21 Gbps는 이미 데이터 전송률입니다. PAM4는 이것을 10.5 Gbaud의 symbol로 보냅니다. NRZ로 환산하면 21 Gbps NRZ와 같은 데이터 양을 절반의 symbol rate로 보내는 것입니다.
#GDDR을 DDR5의 대체품으로 가정
GDDR은 그래픽용 DRAM입니다. 큰 대역폭이 필요한 APU도 GDDR 대신 LPDDR을 넓게 씁니다. AMD Ryzen AI Max+ 395(Strix Halo)는 256-bit LPDDR5X-8000을 씁니다.
#“데이터센터 추론 카드는 GDDR6X”
NVIDIA L4(24 GB)와 L40(48 GB)은 GDDR6입니다.
#정리
- GDDR은 chip당 32-bit bus를 그대로 두고 pin rate를 끌어올린 경로입니다.
- *NRZ(GDDR6, 최대 16 Gbps)*에서 PAM4(GDDR6X, 21 Gbps), *PAM3(GDDR7, 최대 48 Gbps)*로 signaling 자체가 바뀌었습니다.
- PAM4는 NRZ 대비 −9.5 dB, PAM3는 −6.0 dB SNR 불리를 안고 UI당 더 많은 bit를 보냅니다.
- PAM4 21 Gbps의 symbol rate는 10.5 Gbaud, UI는 약 95 ps입니다.
- GDDR7은 chip당 최대 192 GB/s, 독립 channel 4개, on-die ECC를 표준으로 갖습니다.
#다음 편
Ch 5: 대역폭 계산과 병목 분석에서는 공칭 대역폭과 실제 대역폭의 차이, roofline model, memory wall을 봅니다. AI workload에서 왜 대역폭이 늘 부족한지 정량적으로 풉니다.
#관련 항목
- Ch 3: HBM 세대 비교
- Ch 5: 대역폭 계산과 병목 분석
- Ch 6: 열 설계와 전력 관리
- UCIe Ch 3: 물리 레이어 — 고속 signaling 일반론
- BoW Ch 2: 아키텍처 — forwarded clock signaling 대안
HBM·GDDR 심화 · 4 of 12
- 1 HBM과 GDDR 분기점 분석 — Bandwidth·Capacity·Cost 트레이드오프
- 2 HBM 3D 스택 구조 분해 — TSV·Microbump·Base Die의 역할
- 3 HBM2·HBM2E·HBM3·HBM3E 세대 비교 — JEDEC 표준 진화 흐름
- 4 GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로
- 5 메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall
- 6 HBM 열 설계와 전력 관리 — Stack 열 부하·Refresh Cost·냉각 솔루션
- 7 HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling
- 8 NPU·GPU에서의 HBM 활용 — Weight·Activation·KV Cache 배치 분석
- 9 CXL.mem 분석 — HBM·GDDR·DDR 다음의 메모리 계층
- 10 CXL.mem 프로토콜 분해 — 왕복 횟수가 만드는 지연, 링크가 만드는 대역폭
- 11 CXL Type 1·2·3 디바이스 분류 — 이 중 무엇이 나에게 메모리인가
- 12 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일
관련 글
메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall
Theoretical vs achievable — 메모리 대역폭의 실제와 roofline·memory wall.
같은 시리즈에서 이어 읽기
HBM 열 설계와 전력 관리 — Stack 열 부하·Refresh Cost·냉각 솔루션
HBM stack의 전압·열 구조, 온도와 refresh, 냉각 방식과 thermal throttling.
같은 시리즈에서 이어 읽기
Ch 19: 고급 기능 — Lane Margining·10-bit Tag·TPH·ACS·L0p
코어 동작 너머의 PCIe spec 기능들 — Lane Margining(신호 마진 측정)·10-bit Tag(outstanding 확장)·TPH(캐시 주입 힌트)·ACS(격리)·L0p(부분폭 저전력)을 실무 관점에서 정리합니다.
같은 분야의 다른 시리즈