HBM2·HBM2E·HBM3·HBM3E 세대 비교 — JEDEC 표준 진화 흐름
#한 줄 요약
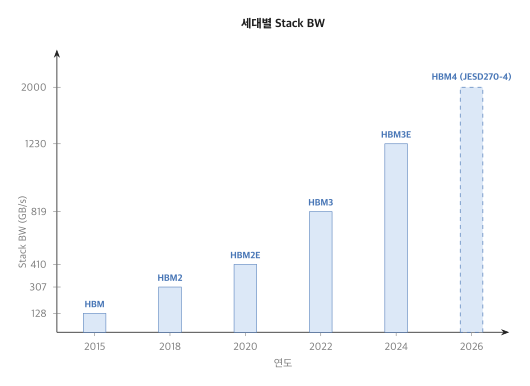
“세대마다 pin rate 1.5~2배가 표준 행보입니다.” — HBM2(2.4 Gbps) → HBM2E(3.6) → HBM3(6.4) → HBM3E(9.6) 순으로 pin rate가 뛰었습니다. stack당 bandwidth는 *307 GB/s(2018) → 1.23 TB/s(2024)*로 6년 만에 4배가 됐습니다. HBM4는 *bus width를 2배(2048-bit)*로 늘려, pin rate는 최대 8 Gbps로 오히려 낮추고도 대역폭을 최대 2 TB/s로 올렸습니다.
Ch 2에서 물리적 구조를 봤습니다. 이번 장은 시간 축입니다. 같은 base die + DRAM die 골격이 세대마다 어떻게 진화했는지, JEDEC 표준이 어떤 새 기능을 더했는지를 봅니다.
#한눈에 보는 표
| 세대 | JEDEC 표준 | 양산 시기 | per-pin | Stack BW | Stack capacity | I/O | VDD |
|---|---|---|---|---|---|---|---|
| HBM | JESD235 | 2015 | 1.0 Gbps | 128 GB/s | TBD | 1024-bit | 1.2 V |
| HBM2 | JESD235A·B | 2016 | 2.0~2.4 Gbps | 256~307 GB/s | 4·8 GB | 1024-bit | TBD |
| HBM2E | JESD235C | 2020 | 3.2~3.6 Gbps | 410~460 GB/s | 16 GB | 1024-bit | TBD |
| HBM3 | JESD238 | 2022 | 6.4 Gbps | 819 GB/s | 16·24 GB | 1024-bit | 1.1 V |
| HBM3E | TBD | 2024 | 9.2~9.6 Gbps | 1.18~1.23 TB/s | 24·36 GB | 1024-bit | TBD |
| HBM4 | JESD270-4 | 2026 | 최대 8.0 Gbps | 최대 2.0 TB/s | 최대 64 GB | 2048-bit | 1.0·1.05 V |
(JEDEC 문서 번호·revision은 시기에 따라 갱신됩니다. HBM4는 2025년 4월 JESD270-4로 표준이 확정됐습니다. JESD235 계열이 아니라 새 번호 체계를 씁니다. HBM2의 2.4 Gbps는 2018년 JESD235B에서, HBM2E의 3.2 Gbps는 2020년 JESD235C에서 정의됐습니다. HBM2E의 3.6 Gbps·460 GB/s는 JEDEC 정격 위로 SK hynix가 낸 제품 속도입니다. 양산 시기와 HBM2E 이후 칸의 속도·용량은 벤더의 양산 발표 기준이고, 근거를 찾지 못한 칸은 TBD로 두었습니다. HBM4의 VDD 칸은 core 전압(VDDC)이고, I/O 전압 VDDQ는 0.7~0.9 V 중 벤더가 고릅니다.)
각 세대의 변곡점을 짚어 가겠습니다.
#HBM (2015) — 시작
AMD Radeon R9 Fury X(Fiji)와 함께 처음 양산된 세대입니다. 메모리는 SK hynix가 만들었습니다.
HBM (1세대):
| 항목 | 값 |
|---|---|
| per-pin | 1.0 Gbps |
| bus | 1024-bit |
| stack BW | 128 GB/s |
| channel | 8 × 128-bit |
| max stack | TBD |
| max capacity | TBD |
| VDD | 1.2 V |
대표 카드 — AMD Radeon R9 Fury X (4 stack, 4 GB, 4096-bit, 512 GB/s).
7 Gbps GDDR5를 256-bit로 묶으면 224 GB/s입니다. HBM은 stack 4개로 그 두 배가 넘는 대역폭을 냈습니다.
#HBM2 (2016) — 본격화
JESD235A(2016)가 2.0 Gbps를, JESD235B(2018)가 2.4 Gbps와 12-Hi·고용량 구성을 정의했습니다.
HBM2:
| 항목 | 값 |
|---|---|
| per-pin | 2.0 Gbps (JESD235B: 2.4 Gbps) |
| stack BW | 256 GB/s (JESD235B: 307 GB/s) |
| channel | 8 × 128-bit, 또는 pseudo channel 16 × 64-bit |
| max stack | 8-Hi (JESD235B: 12-Hi) |
| max capacity | 8 GB / stack (JESD235B: 24 GB) |
| ECC | TBD |
대표 카드 — NVIDIA V100 (4 stack, 16 GB, 900 GB/s), NVIDIA A100 40GB (5 stack, 1,555 GB/s).
핵심 변화는 Pseudo Channel입니다. 128-bit channel 하나를 64-bit 두 개로 나눕니다. 두 pseudo channel은 address·command bus를 공유하지만 명령은 각자 해석해 실행합니다. HBM1과 같은 128-bit 채널 8개 방식은 legacy mode로 남았습니다.
PC 도입 전 (HBM):
- Channel 0 (128-bit) ─── 한 번에 한 명령
PC 도입 후 (HBM2):
- Channel 0
- ├── PC0 (64-bit) ─── 독립 명령 A
- └── PC1 (64-bit) ─── 독립 명령 B
#HBM2E (2020) — 중간 단계
JESD235C(2020)가 per-pin 3.2 Gbps를 정의했습니다. 벤더는 그 위 속도의 제품도 냈습니다.
HBM2E (2020):
| 항목 | 값 |
|---|---|
| per-pin | 3.2 Gbps (JESD235C, Samsung Flashbolt), 3.6 Gbps (SK hynix) |
| stack BW | 410 GB/s, 460 GB/s |
| max stack | 8-Hi |
| max capacity | 16 GB / stack (16 Gb DRAM × 8) |
대표 카드 — NVIDIA A100 80GB (80 GB, 2 TB/s 이상), NVIDIA H100 PCIe (5 stack, 80 GB).
per-pin이 2.4 → 3.6 Gbps로 50% 증가했고, DRAM die가 16 Gb로 커져 stack 하나가 16 GB가 됐습니다.
#HBM3 (2022) — 세대 변곡
JEDEC가 큰 폭의 사양 변경을 한 세대입니다.
HBM3 (JESD238, 2022년 1월):
| 항목 | 값 |
|---|---|
| per-pin | 6.4 Gbps |
| stack BW | 819 GB/s |
| channel | 16 (HBM2의 8에서 두 배) |
| pseudo channel | channel당 2개 (가상 32 channel) |
| max stack | 12-Hi (16-Hi 확장 조항) |
| capacity | 규격상 4~64 GB, 1세대 제품 16·24 GB |
| VDD | 1.1 V, I/O 0.4 V low-swing |
| ECC | on-die ECC (symbol 기반) |
대표 카드 — NVIDIA H100 SXM5 (5 stack, 80 GB, 3.35 TB/s), AMD Instinct MI300X (192 GB, 5.3 TB/s).
채널 수 두 배. 독립 channel이 8개에서 16개로 늘었고, channel마다 pseudo channel이 2개라 가상 32 channel이 동시에 명령을 받을 수 있습니다.
on-die ECC 표준화. HBM3부터 symbol 기반 ECC가 DRAM die 안에 들어갑니다.
clock 구조 변경. command clock(CK)과 data strobe(WDQS·RDQS)가 분리됐습니다. 6.4 Gbps에서 data strobe는 3.2 GHz, CK는 최대 1.6 GHz입니다.
#HBM3E (2024)
NVIDIA H200(141 GB, 4.8 TB/s)과 B200(8 TB/s)이 HBM3e를 씁니다.
HBM3E — 벤더별 양산 제품:
| 벤더 | per-pin | stack BW (× 1024-bit) | 구성 | 양산 발표 |
|---|---|---|---|---|
| Micron | 9.2 Gbps | 1.18 TB/s | 8-Hi, 24 GB | 2024년 2월 |
| SK hynix | 9.6 Gbps | 1.23 TB/s | 12-Hi, 36 GB | 2024년 9월 |
| Samsung | TBD | TBD | TBD | TBD |
12-Hi 36 GB stack은 24 Gb DRAM die 12장입니다.
#HBM4 (2025) — 광폭 인터페이스로
HBM4는 흐름을 바꿉니다. pin rate를 크게 올리는 대신 *bus width를 2배(2048-bit)*로 늘렸습니다.
HBM4 (JESD270-4, 2025년 4월):
| 항목 | 값 |
|---|---|
| per-pin | 최대 8 Gbps |
| bus | 2048-bit (1024-bit에서 2배) |
| stack BW | 최대 2 TB/s |
| channel | 32 (HBM3의 16에서 두 배), channel당 pseudo channel 2개 |
| stack | 4·8·12·16-Hi |
| DRAM die | 24 Gb 또는 32 Gb |
| max capacity | 64 GB / stack (32 Gb × 16) |
| VDDC / VDDQ | 1.0·1.05 V / 0.7·0.75·0.8·0.9 V (벤더 선택) |
| RAS | DRFM(directed refresh management) |
| 호환 | 기존 HBM3 controller와 하위 호환 |
#RAS — 신뢰성 기능
세대마다 Reliability·Availability·Serviceability 기능이 강화됐습니다.
| 세대 | RAS 기능 |
|---|---|
| HBM2 | TBD |
| HBM2E | TBD |
| HBM3 | on-die ECC(symbol 기반) 표준화 |
| HBM3E | TBD |
| HBM4 | DRFM(directed refresh management)으로 row hammer 대응 |
AI training cluster는 수만 개의 stack을 몇 주씩 쉬지 않고 돌립니다. stack 수가 이만큼 많으면 드문 soft error도 클러스터 전체로는 자주 일어나고, 오류 하나가 긴 training job을 멈출 수 있습니다. 그래서 HBM3부터 on-die ECC가 표준에 들어가고 RAS가 사실상 필수가 됐습니다.
#bandwidth 그래프
세대별 stack 1개의 bandwidth 진화입니다.
GPU 카드 한 장의 총 BW는 다음과 같습니다. stack당 실효 BW는 총 BW를 stack 수로 나눈 값입니다.
| 카드 | HBM | stack 수 | 총 BW | stack당 실효 BW |
|---|---|---|---|---|
| V100 (16 GB) | HBM2 | 4 | 900 GB/s | 225 GB/s |
| A100 (40 GB) | HBM2 | 5 | 1,555 GB/s | 311 GB/s |
| H100 SXM5 | HBM3 | 5 | 3.35 TB/s | 670 GB/s |
| H200 | HBM3e | — | 4.8 TB/s | — |
| B200 | HBM3e | — | 8 TB/s | — |
stack당 실효 BW가 세대 최대치(HBM3라면 819 GB/s)보다 낮은 것은 카드가 HBM을 정격 최대 속도보다 낮게 돌리기 때문입니다. H200·B200의 stack 수는 NVIDIA 공개 자료에 나오지 않아 비워 두었습니다.
8년 만에 6.25배가 늘었습니다. 같은 기간 GPU compute는 25배(FP16 기준)가 늘었습니다. compute가 더 빠르게 늘어 memory가 병목이 되는 흐름이 확실합니다. Ch 5에서 이 memory wall을 자세히 봅니다.
#자주 하는 실수
#“HBM3E와 HBM3가 같은 슬롯에 호환된다”
JEDEC 핀·신호 정의는 세대마다 다르고, interposer 라우팅도 패키지마다 정해집니다. 그래서 다 만든 보드에서 HBM만 다음 세대로 바꿔 끼울 수는 없습니다. 세대를 고르는 곳은 패키지 설계 단계입니다. NVIDIA GH100 die가 좋은 예입니다. die 자체는 HBM3와 HBM2e를 모두 지원하지만, H100 SXM5는 HBM3로, H100 PCIe는 HBM2e로 패키지를 따로 만들었습니다. H200은 같은 Hopper 세대 GPU에 HBM3e를 붙인 제품입니다.
#per-pin rate를 channel rate와 혼동
HBM3 per-pin은 6.4 Gbps입니다. 그런데 DDR이라서 effective rate는 12.8 Gbps 같은 식의 오해가 있습니다. JEDEC HBM3 사양에서 6.4 Gbps는 이미 DDR을 포함한 effective rate입니다. 이 속도에서 data strobe(WDQS·RDQS)는 3.2 GHz로 돌고, host가 보내는 CK는 최대 1.6 GHz에 머뭅니다. HBM3부터 command clock과 data strobe가 분리됐기 때문입니다.
#“Samsung·SK·Micron이 같은 9.6 Gbps다”
벤더마다 몇 Gbps grade가 다릅니다. GPU 벤더가 qualification하는 part number도 벤더·grade별로 따로입니다. *데이터시트의 ‘grade’*를 보지 않고 세대 이름만으로 같다고 가정하면 BOM에 문제가 생깁니다.
#HBM4를 HBM3E의 단순한 클럭 업그레이드로 가정
HBM4는 bus width 자체가 2배입니다. JEDEC는 HBM4가 기존 HBM3 controller와 하위 호환된다고 밝혔지만, 2048개 신호를 잇는 interposer 라우팅은 1024-bit 설계를 그대로 쓸 수 없습니다. 패키지는 새로 설계해야 합니다.
#정리
- HBM은 2015년 1세대(128 GB/s) 이후 9년 만에 stack BW가 약 10배(1.23 TB/s)로 늘었습니다.
- 세대 간 변곡점은 HBM2(PC 도입), HBM3(channel 16개·1.1 V·on-die ECC), HBM4(2048-bit bus)입니다.
- per-pin rate는 1.0 → 9.6 Gbps까지 올라갔습니다.
- DRAM die 밀도도 8 → 16 → 24 Gb로 늘어 stack capacity를 36 GB까지 끌어올렸습니다.
- HBM3에서 on-die ECC가 표준에 들어갔습니다.
- HBM4는 pin rate 대신 *bus width(2048-bit)*를 늘려 대역폭을 올렸습니다.
- 벤더별 pin rate grade가 다르므로 세대 이름만으로 호환을 가정하면 안 됩니다.
- 다음 장에서 반대편의 GDDR을 봅니다. 32 Gbps per-pin이 어떻게 가능한지가 핵심입니다.
#다음 편
Ch 4: GDDR6·GDDR6X·GDDR7에서는 PAM4·PAM3 같은 멀티 레벨 signaling이 어떻게 pin rate를 32 Gbps까지 끌어올렸는지 봅니다. PCB 라우팅과 signal integrity 부담도 같이 다룹니다.
#관련 항목
- Ch 1: 고대역 메모리 개요
- Ch 2: HBM 스택 구조와 TSV
- Ch 4: GDDR6·GDDR6X·GDDR7
- Ch 5: 대역폭 계산과 병목 분석
- UCIe Ch 5: 버전 비교 — 표준 세대 진화 패턴
HBM·GDDR 심화 · 3 of 12
- 1 HBM과 GDDR 분기점 분석 — Bandwidth·Capacity·Cost 트레이드오프
- 2 HBM 3D 스택 구조 분해 — TSV·Microbump·Base Die의 역할
- 3 HBM2·HBM2E·HBM3·HBM3E 세대 비교 — JEDEC 표준 진화 흐름
- 4 GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로
- 5 메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall
- 6 HBM 열 설계와 전력 관리 — Stack 열 부하·Refresh Cost·냉각 솔루션
- 7 HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling
- 8 NPU·GPU에서의 HBM 활용 — Weight·Activation·KV Cache 배치 분석
- 9 CXL.mem 분석 — HBM·GDDR·DDR 다음의 메모리 계층
- 10 CXL.mem 프로토콜 분해 — 왕복 횟수가 만드는 지연, 링크가 만드는 대역폭
- 11 CXL Type 1·2·3 디바이스 분류 — 이 중 무엇이 나에게 메모리인가
- 12 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일
관련 글
GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로
고속 그래픽 메모리 — clock·PAM 신호의 진화로 32 Gbps에 도달한 경로.
같은 시리즈에서 이어 읽기
메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall
Theoretical vs achievable — 메모리 대역폭의 실제와 roofline·memory wall.
같은 시리즈에서 이어 읽기
실전 사례 — CXL.mem 추가로 LLM inference KV cache 처리량 회복
70B 모델 KV cache가 HBM 한계를 넘어 throughput이 무너졌을 때, CXL.mem 256 GB pool 추가로 회복한 실전 케이스.
공통 태그 기반 추천
이 글을 참조하는 글 (5)
- 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일 — HBM·GDDR 심화
- 메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall — HBM·GDDR 심화
- GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로 — HBM·GDDR 심화
- HBM 3D 스택 구조 분해 — TSV·Microbump·Base Die의 역할 — HBM·GDDR 심화
- HBM과 GDDR 분기점 분석 — Bandwidth·Capacity·Cost 트레이드오프 — HBM·GDDR 심화