HBM 열 설계와 전력 관리 — Stack 열 부하·Refresh Cost·냉각 솔루션
#한 줄 요약
“HBM은 작은 면적에 die를 여러 장 쌓은 메모리라 열이 빠지기 어렵습니다.” — 온도가 오르면 DRAM은 refresh를 더 자주 해야 하고, GPU는 메모리 온도가 한계를 넘으면 clock을 낮춥니다. 그래서 HBM 시스템에서는 cooling이 곧 대역폭 관리입니다. GPU를 rack 하나에 많이 몰아넣는 시스템(GB200 NVL72)은 liquid cooling으로 설계됐습니다.
Ch 5에서 bandwidth가 어디서 깎이는지를 봤습니다. 이번 장에서는 그 bandwidth를 유지하는 데 드는 전력과 그 전력이 만드는 열을 봅니다.
#전압부터
JEDEC HBM3(JESD238)는 core 전압을 1.1 V로 낮추고, I/O는 0.4 V low-swing 신호를 씁니다. HBM4(JESD270-4)는 core 전압(VDDC)이 1.0 V 또는 1.05 V, I/O 전압(VDDQ)은 0.7~0.9 V 중 벤더가 고릅니다. 세대가 바뀔 때마다 전압을 낮추는 이유는 같은 대역폭을 더 적은 전력으로 내기 위해서입니다. stack 하나의 세부 전력 분해는 벤더가 공개하지 않습니다.
#stack의 열 구조
HBM stack은 base die 위에 DRAM die를 여러 장 쌓고, 그 위를 cold plate가 덮는 구조입니다.
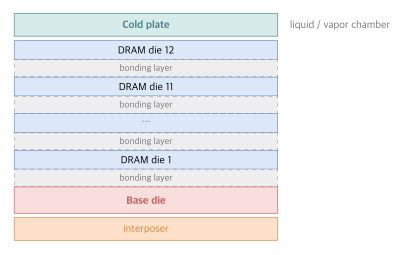
die를 여러 장 쌓았기 때문에 아래쪽 die의 열은 위의 die들을 지나야 cold plate에 닿습니다. 같은 면적에서 열원이 여러 층으로 겹친다는 점이 2D 칩과 다릅니다.
#Refresh — 온도와 맞물리는 비용
DRAM 데이터는 capacitor에 전하 형태로 저장됩니다. 시간이 지나면 leakage로 사라지므로 주기적인 refresh로 다시 채웁니다. leakage는 온도가 오를수록 빨라지므로, 뜨거운 DRAM은 refresh를 더 자주 해야 합니다. refresh 중인 bank는 read·write를 받을 수 없으니, 온도가 오르면 쓸 수 있는 대역폭이 줄고 refresh 전력은 늘어납니다.
HBM 세대별 refresh 주기와 온도 구간 값은 JEDEC 규격 원문에 있습니다. 이 장에서는 TBD로 둡니다.
#Cooling 솔루션
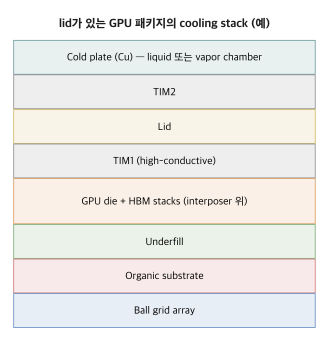
HBM은 interposer 위에 GPU/NPU 옆에 붙어 있어서, cooling이 GPU die와 HBM을 함께 처리해야 합니다.
| 제품 | TDP / 전력 | Cooling |
|---|---|---|
| NVIDIA A100 (SXM) | 400 W | TBD |
| NVIDIA H100 SXM | 최대 700 W | TBD |
| NVIDIA DGX B200 (B200 × 8) | 시스템 최대 약 14.3 kW | 공랭(air-cooled) 구성 |
| NVIDIA GB200 NVL72 | TBD | rack 단위 liquid cooling (Blackwell GPU 72개) |
B200을 쓴다고 해서 곧바로 liquid cooling이 필요한 것은 아닙니다. NVIDIA는 DGX B200을 공랭으로 내놓았고, GPU 72개를 한 rack에 묶은 GB200 NVL72는 liquid cooling으로 설계했습니다. 냉각 방식은 GPU 한 장보다 rack에 얼마나 몰아넣느냐로 갈립니다.
#Thermal throttling
GPU는 메모리 온도가 최대 동작 온도를 넘지 않도록 clock을 낮춥니다. NVIDIA GPU에서는 nvidia-smi로 메모리 온도와 clock 제한 사유를 함께 볼 수 있습니다.
# 메모리 온도와 clock 제한 사유nvidia-smi --query-gpu=temperature.memory,clocks_event_reasons.active --format=csv
# 출력 예temperature.memory, clocks_event_reasons.active92, 0x0000000000000020 # SW Thermal Slowdownclocks_event_reasons.active는 비트마스크입니다. NVML 헤더(nvml.h)의 정의는 다음과 같습니다.
| 비트 | 이름 | 의미 |
|---|---|---|
0x04 | SwPowerCap | 소프트웨어 전력 제한 |
0x20 | SwThermalSlowdown | GPU 온도 또는 메모리 온도가 최대 동작 온도를 넘지 않도록 clock을 낮춤 |
0x40 | HwThermalSlowdown | 온도가 너무 높아 하드웨어가 core clock을 절반 이하로 낮춤 |
HBM 온도 때문에 clock이 내려가면 0x20이 켜집니다. 0x04는 전력 제한이지 메모리 온도와는 관계가 없습니다.
#자주 하는 실수
#“B200부터는 liquid cooling이 필수다”
NVIDIA DGX B200은 공랭 구성입니다. liquid cooling이 필요한 것은 GB200 NVL72처럼 rack 하나에 GPU를 많이 몰아넣는 설계입니다.
#clock 제한 비트를 잘못 읽기
0x04(SwPowerCap)를 보고 열 문제로 판단하면 틀립니다. 메모리 온도 때문이면 0x20, 하드웨어 열 보호가 걸리면 0x40입니다.
#RTX 카드의 GDDR cooling과 HBM cooling을 동일시
GDDR은 카드 PCB 위 여러 칩으로 흩어져 있고, HBM은 GPU die 옆 좁은 면적에 die를 쌓아 모여 있습니다. 열이 모이는 방식이 다르니 cooling 설계도 달라집니다.
#정리
- HBM3는 core 1.1 V·I/O 0.4 V low-swing, HBM4는 VDDC 1.0·1.05 V로 전압을 낮춰 왔습니다.
- die를 쌓은 구조라 아래 die의 열이 위 die를 지나 cold plate로 갑니다.
- 온도가 오르면 refresh가 잦아지고, 그만큼 쓸 수 있는 대역폭이 줄어듭니다.
- 냉각 방식은 rack 밀도로 갈립니다. DGX B200은 공랭, GB200 NVL72는 liquid cooling입니다.
- 메모리 온도로 clock이 내려가면 NVML의
SwThermalSlowdown(0x20)이 켜집니다.
#다음 편
Ch 7: 메모리 컨트롤러 인터페이스에서는 bank·row·column 계층, command scheduling, address mapping 같은 컨트롤러 설계의 핵심을 다룹니다.
#관련 항목
HBM·GDDR 심화 · 6 of 12
- 1 HBM과 GDDR 분기점 분석 — Bandwidth·Capacity·Cost 트레이드오프
- 2 HBM 3D 스택 구조 분해 — TSV·Microbump·Base Die의 역할
- 3 HBM2·HBM2E·HBM3·HBM3E 세대 비교 — JEDEC 표준 진화 흐름
- 4 GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로
- 5 메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall
- 6 HBM 열 설계와 전력 관리 — Stack 열 부하·Refresh Cost·냉각 솔루션
- 7 HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling
- 8 NPU·GPU에서의 HBM 활용 — Weight·Activation·KV Cache 배치 분석
- 9 CXL.mem 분석 — HBM·GDDR·DDR 다음의 메모리 계층
- 10 CXL.mem 프로토콜 분해 — 왕복 횟수가 만드는 지연, 링크가 만드는 대역폭
- 11 CXL Type 1·2·3 디바이스 분류 — 이 중 무엇이 나에게 메모리인가
- 12 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일
관련 글
HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling
Bank·row·column·command — 컨트롤러가 보는 HBM과 scheduling·address mapping.
같은 시리즈에서 이어 읽기
NPU·GPU에서의 HBM 활용 — Weight·Activation·KV Cache 배치 분석
Weight·activation·KV cache — HBM 자리잡기와 시리즈 마무리.
같은 시리즈에서 이어 읽기
실전 사례 — CXL.mem 추가로 LLM inference KV cache 처리량 회복
70B 모델 KV cache가 HBM 한계를 넘어 throughput이 무너졌을 때, CXL.mem 256 GB pool 추가로 회복한 실전 케이스.
공통 태그 기반 추천
이 글을 참조하는 글 (5)
- 메모리 풀링과 데이터센터 토폴로지 — 용량을 서버 밖에서 빌리는 일 — HBM·GDDR 심화
- HBM 메모리 컨트롤러 분석 — Bank·Row·Column·Address Mapping·Scheduling — HBM·GDDR 심화
- 메모리 대역폭 병목 분석 — Theoretical vs Achievable·Roofline·Memory Wall — HBM·GDDR 심화
- GDDR6·GDDR6X·GDDR7 분석 — PAM 신호로 32 Gbps 도달한 경로 — HBM·GDDR 심화
- HBM 3D 스택 구조 분해 — TSV·Microbump·Base Die의 역할 — HBM·GDDR 심화